> ## Documentation Index
> Fetch the complete documentation index at: https://docs.comfy.org/llms.txt
> Use this file to discover all available pages before exploring further.
# SDPose: detección de poses en ComfyUI
> Aprende a extraer keypoints y mapas de pose de imágenes y videos con SDPose, compatible de forma nativa en ComfyUI
> [!TIP]
>
> **Usuarios locales**
>
> Asegúrate de que tu ComfyUI esté actualizado.
>
> * [Descargar ComfyUI](https://www.comfy.org/download)
> * [Guía de actualización](https://docs.comfy.org/es/installation/update_comfyui.md)
>
> Los flujos de trabajo de esta guía se encuentran en las [Plantillas de flujos de trabajo](https://docs.comfy.org/es/interface/features/template.md).
> Si no los encuentras en las plantillas, es posible que tu ComfyUI esté desactualizado.
>
> Si faltan nodos al cargar un flujo de trabajo, estas son las posibles razones:
>
> 1. No estás usando la última versión de ComfyUI (versión nocturna)
> 2. Algunos nodos fallaron al importarse durante el inicio
>
> **Usuarios de Cloud**
>
> * [Cloud](https://cloud.comfy.org) se actualizará después del lanzamiento estable de ComfyUI.
>
> Por lo tanto, si notas que falta algún nodo central en este documento, puede deberse a que los nuevos nodos centrales aún no se han publicado en la última versión estable. Espera al próximo lanzamiento estable.
SDPose es un modelo de detección de pose de cuerpo completo que extrae keypoints humanos de imágenes y videos. Combinado con el detector de objetos RT-DETRv4, admite detección de varias personas y estimación de pose fuera de dominio (OOD), lo que lo convierte en una herramienta versátil para pipelines de animación, generación guiada por pose y flujos de trabajo de seguimiento de movimiento.
SDPose + RT-DETRv4 son compatibles de forma nativa con ComfyUI (PR [#12748](https://github.com/Comfy-Org/ComfyUI/pull/12748)). Los pesos del modelo están disponibles en Hugging Face.
[Modelo SDPose en Hugging Face](https://huggingface.co/Comfy-Org/SDPose) | [Artículo de RT-DETRv4 (arXiv)](https://arxiv.org/abs/2510.25257) | [Artículo de SDPose (arXiv)](https://arxiv.org/abs/2509.24980)
### Puntos fuertes
* **Keypoints de cuerpo completo**: detecta keypoints de cuerpo, manos, rostro y pies en un modelo unificado
* **Soporte para varias personas**: detecta y etiqueta a varias personas en una sola imagen o video
* **Salidas configurables**: elige qué partes del cuerpo visualizar (cuerpo, manos, rostro, pies) y controla el tamaño del palo y de la fuente
* **Detección de cajas delimitadoras**: incluye detección de objetos con umbrales ajustables y selección de clases
* **Compatibilidad con imágenes y videos**: flujos de trabajo dedicados para imágenes individuales, videos y estimación de pose OOD
> **Limitaciones:** La precisión de la detección depende de la resolución de la imagen y de la visibilidad del sujeto. Los sujetos extremadamente ocluidos o muy pequeños pueden producir menos keypoints.
## Flujos de trabajo de SDPose
Hay cuatro flujos de trabajo disponibles según tu caso de uso:
| Flujo de trabajo | Entrada | Salida | Caso de uso |
| - | - | - | - |
| Multi-Person (Image) | Una sola imagen | Mapa de pose + BBoxes | Fotos con varias personas |
| Multi-Person (Video) | Video | Mapa de pose por fotograma + BBoxes | Seguimiento de pose en video |
| OOD Image to Pose | Una sola imagen | Mapa de pose | Transferencia de estilo / imagen a pose |
| OOD Video to Pose Map | Video | Mapa de pose por fotograma | Animación de video a pose |
### 1. Descargar los flujos de trabajo
Actualiza tu ComfyUI a la última versión, luego ve a `Workflow` -> `Browse Templates` y busca los flujos de trabajo de SDPose en la categoría Utility.
### SDPose: Image Multi-Person Detection
Sube una imagen para detectar poses humanas. Admite la detección de una sola persona y de varias personas en la misma escena.
> **[Ejecutar en Comfy Cloud](https://cloud.comfy.org/?template=utility_sdpose_multi_person\&utm_source=docs\&utm_medium=referral\&utm_campaign=pose-detection-sdpose)**
>
> Abrir en Comfy Cloud
> **[Descargar flujo de trabajo](https://github.com/Comfy-Org/workflow_templates/blob/main/templates/utility_sdpose_multi_person.json)**
>
> Descarga el JSON o busca "SDPose: Image Multi-Person Detection" en la Biblioteca de plantillas
**Materiales de entrada**
Sube este archivo al nodo `LoadImage` correspondiente:
> **[group\_photo.png](https://raw.githubusercontent.com/Comfy-Org/workflow_templates/main/input/group_photo.png)**
>
> Nodo `LoadImage` 679 · `group_photo.png`
### SDPose: Video Multi-Person Detection
Sube un video para detectar poses humanas. Admite la detección de una sola persona y de varias personas en la misma escena.
> **[Ejecutar en Comfy Cloud](https://cloud.comfy.org/?template=utility_sdpose_multi_person_video\&utm_source=docs\&utm_medium=referral\&utm_campaign=pose-detection-sdpose)**
>
> Abrir en Comfy Cloud
> **[Descargar flujo de trabajo](https://github.com/Comfy-Org/workflow_templates/blob/main/templates/utility_sdpose_multi_person_video.json)**
>
> Descarga el JSON o busca "SDPose: Video Multi-Person Detection" en la Biblioteca de plantillas
**Materiales de entrada**
Sube este archivo al nodo `LoadVideo` correspondiente:
> **[man\_playing\_violin.mp4](https://raw.githubusercontent.com/Comfy-Org/workflow_templates/main/input/man_playing_violin.mp4)**
>
> Nodo `LoadVideo` 694 · `man_playing_violin.mp4`
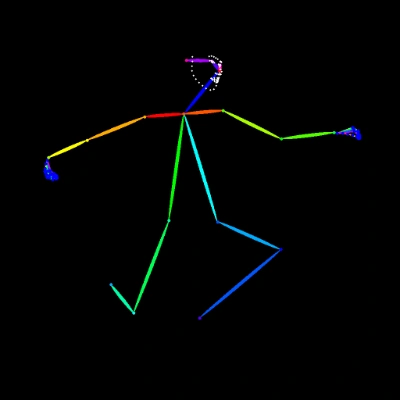
### SDPose-OOD: Image to Pose Map
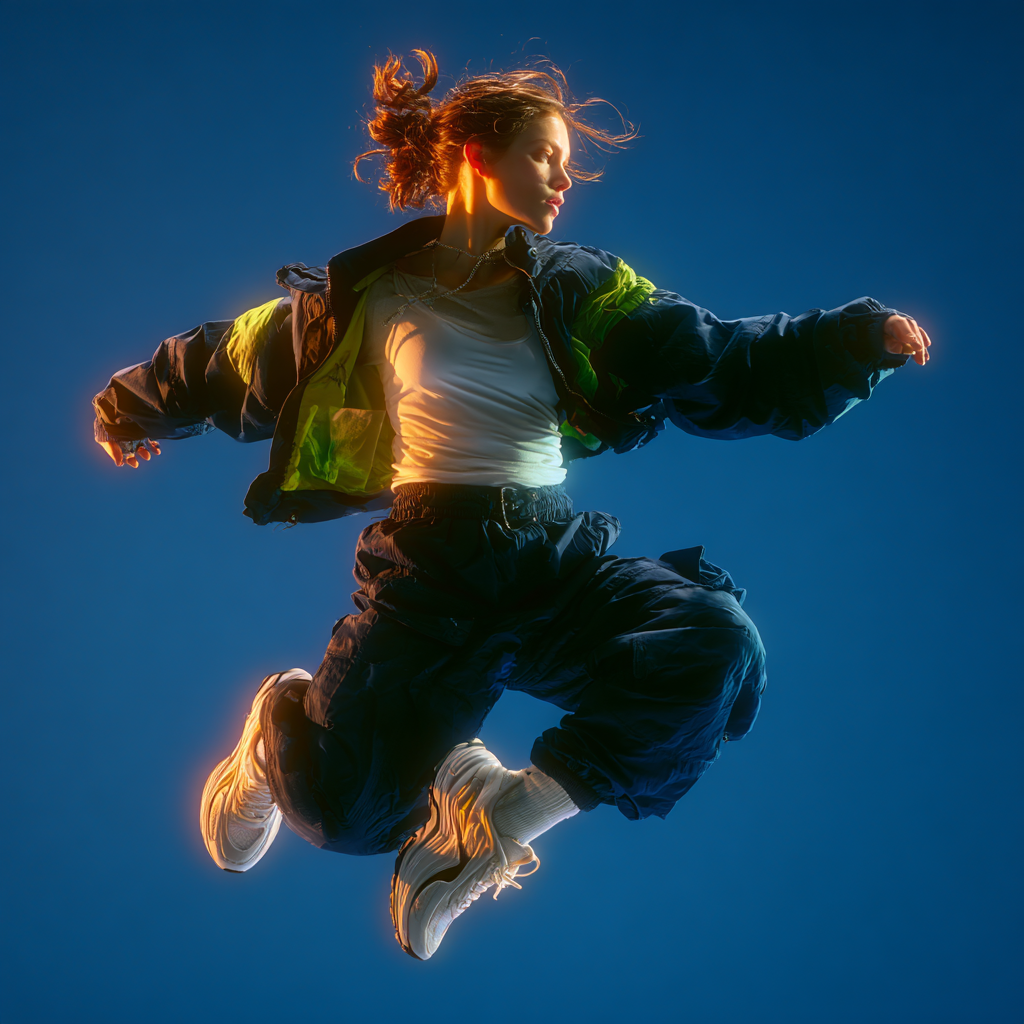
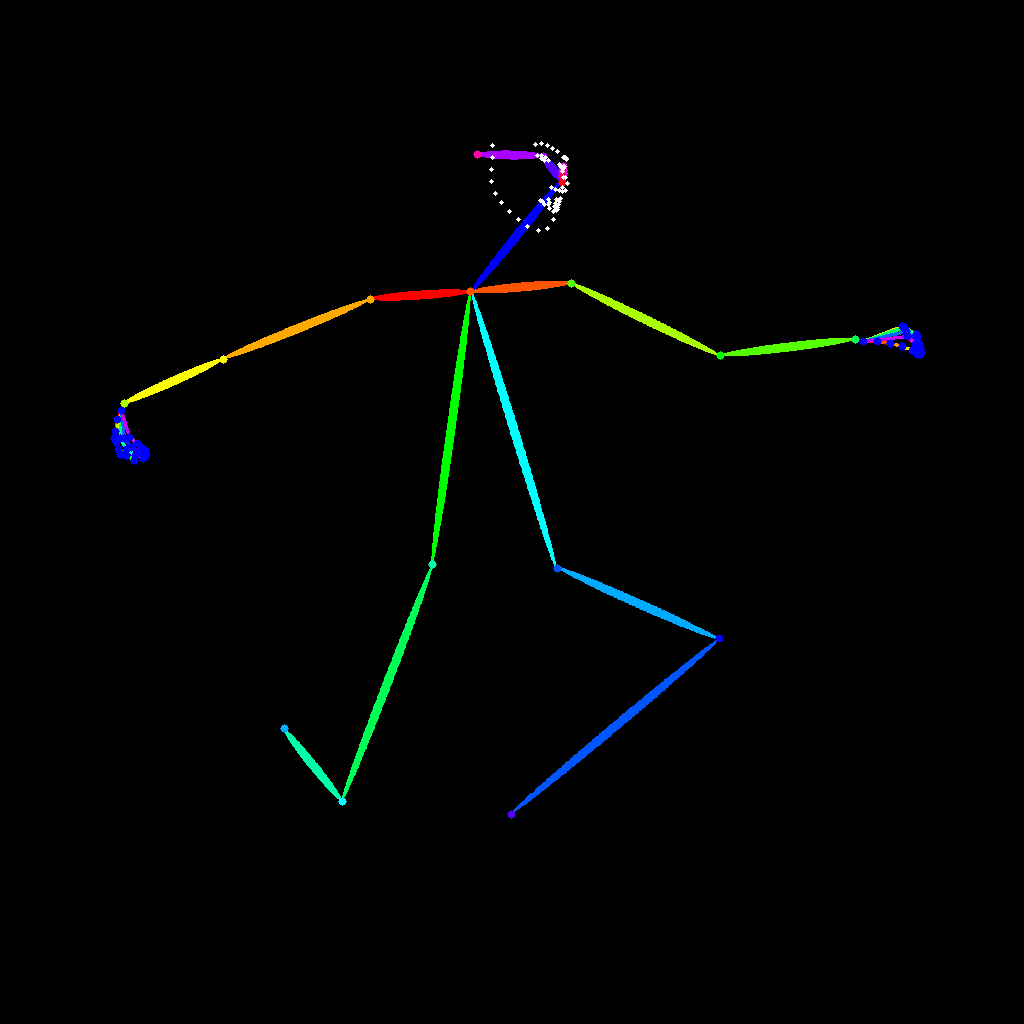
Sube una imagen para extraer los keypoints de la pose y generar el mapa de pose correspondiente con el modelo SDPose-OOD.
> **[Ejecutar en Comfy Cloud](https://cloud.comfy.org/?template=utility_sdpose_ood_image_to_pose\&utm_source=docs\&utm_medium=referral\&utm_campaign=pose-detection-sdpose)**
>
> Abrir en Comfy Cloud
> **[Descargar flujo de trabajo](https://github.com/Comfy-Org/workflow_templates/blob/main/templates/utility_sdpose_ood_image_to_pose.json)**
>
> Descarga el JSON o busca "SDPose-OOD: Image to Pose Map" en la Biblioteca de plantillas
**Materiales de entrada**
Sube este archivo al nodo `LoadImage` correspondiente:
> **[dancer.png](https://raw.githubusercontent.com/Comfy-Org/workflow_templates/main/input/dancer.png)**
>
> Nodo `LoadImage` 667 · `dancer.png`
**Salida de ejemplo**
### SDPose-OOD: Video to Pose Map
Sube un video para extraer los keypoints de la pose y generar un mapa de pose. El flujo de trabajo admite la detección de varias personas y usa un modelo SDPose mejorado para extraer las características de todo el cuerpo con precisión.
> **[Ejecutar en Comfy Cloud](https://cloud.comfy.org/?template=utility_sdpose_ood_video_to_pose_map\&utm_source=docs\&utm_medium=referral\&utm_campaign=pose-detection-sdpose)**
>
> Abrir en Comfy Cloud
> **[Descargar flujo de trabajo](https://github.com/Comfy-Org/workflow_templates/blob/main/templates/utility_sdpose_ood_video_to_pose_map.json)**
>
> Descarga el JSON o busca "SDPose-OOD: Video to Pose Map" en la Biblioteca de plantillas
**Materiales de entrada**
Sube este archivo al nodo `LoadVideo` correspondiente:
> **[man\_in\_the\_rain.mp4](https://raw.githubusercontent.com/Comfy-Org/workflow_templates/main/input/man_in_the_rain.mp4)**
>
> Nodo `LoadVideo` 679 · `man_in_the_rain.mp4`
**Salida de ejemplo**
### 2. Descargar los modelos
Los checkpoints de los modelos SDPose y RT-DETRv4 están en el [repositorio del modelo SDPose de Comfy-Org](https://huggingface.co/Comfy-Org/SDPose).
**checkpoints** (modelo SDPose):
* [sdpose\_wholebody\_fp16.safetensors](https://huggingface.co/Comfy-Org/SDPose/blob/main/checkpoints/sdpose_wholebody_fp16.safetensors)
**diffusion\_models** (detector RT-DETRv4):
* [rt\_detr\_v4-x-hgnet\_fp16.safetensors](https://huggingface.co/Comfy-Org/SDPose/blob/main/diffusion_models/rt_detr_v4-x-hgnet_fp16.safetensors) (recomendado)
* [rt\_detr\_v4-x-hgnet\_fp32.safetensors](https://huggingface.co/Comfy-Org/SDPose/blob/main/diffusion_models/rt_detr_v4-x-hgnet_fp32.safetensors) (precisión completa, más grande)
Colócalos con la siguiente estructura de directorios:
```
📂 ComfyUI/
└── 📂 models/
├── 📂 checkpoints/
│ └── sdpose_wholebody_fp16.safetensors
└── 📂 diffusion_models/
├── rt_detr_v4-x-hgnet_fp16.safetensors
└── rt_detr_v4-x-hgnet_fp32.safetensors
```
### 3. Usar los flujos de trabajo
#### Multi-Person (Image)
* **Entrada**: carga una imagen con el nodo `Load Image`. Usa una imagen con una o varias personas (ejemplo: `group_photo.png`).
* **Detección**: el subgrafo `Image to Pose Map (SDPose Multi-Person)` procesa la imagen y genera:
* **IMAGE**: visualización del esqueleto de la pose superpuesto a la imagen
* **keypoints**: datos brutos de los keypoints de todo el cuerpo
* **bboxes**: coordenadas de las cajas delimitadoras
* **Opciones de dibujo**: configura qué partes del cuerpo se dibujan:
* `draw_body`, `draw_hands`, `draw_face`, `draw_feet`: activan o desactivan la visibilidad
* `stick_width`, `face_point_size`: ajustan el estilo visual
* `score_threshold`: confianza mínima para mostrar los keypoints
* **Opciones de detección**:
* `resize_type.longer_size`: escala el lado más largo antes de la detección
* `max_detections`: número máximo de personas a detectar
* `detect_threshold`: umbral de confianza de la detección
* `detect_class`: clase de objeto a detectar (predeterminado: person)
#### Multi-Person (Video)
Igual que el flujo de trabajo de imagen, pero procesa los fotogramas del video uno tras otro. Usa `Load Video` para introducir un archivo de video y `Save Video` para exportar el resultado.
#### OOD Image to Pose
Usa el modelo SDPose para generar un mapa de pose limpio a partir de una imagen, sin visualización de cajas delimitadoras. Resulta útil para la transferencia de estilo, cuando quieres extraer la pose del esqueleto de una imagen y aplicarla a otra.
#### OOD Video to Pose Map
Genera mapas de pose por fotograma a partir de un video. La salida es un archivo de video en el que cada fotograma contiene el esqueleto de la pose extraído, apto para animación posterior o para flujos de trabajo de ControlNet.
> **[Aprende sobre Subgraph](https://docs.comfy.org/es/interface/features/subgraph.md)**
>
> Estos flujos de trabajo usan nodos Subgraph para el procesamiento modular. Consulta la documentación de Subgraph para aprender a personalizar y ampliar los flujos de trabajo.
## Notas adicionales
* **Directorio de modelos**: el checkpoint de SDPose va en `models/checkpoints/`, y el detector RT-DETRv4 va en `models/diffusion_models/`
* **Ejemplo de imagen de entrada**: el archivo `group_photo.png` está disponible en el directorio `input/` de la plantilla del flujo de trabajo para hacer pruebas
* **Salida de puntos clave**: el tipo POSE\_KEYPOINT se puede conectar a nodos posteriores que aceptan datos de pose para la generación condicional
* **Actualización necesaria**: el soporte de SDPose + RT-DETRv4 está disponible en versiones recientes de ComfyUI. Asegúrate de que tu ComfyUI esté actualizado.
This documentation is built and hosted on [Mintlify](https://mintlify.com), a developer documentation platform.