

- Multimodal: acepta entradas de texto e imagen para tareas de comprensión visual
- Descripción de imágenes: puede describir imágenes y generar descripciones detalladas
- Ingeniería inversa de prompts: extrae prompts y parámetros de generación a partir de imágenes de referencia
- Nativo en ComfyUI: funciona con el nodo integrado
TextGenerate, sin necesidad de nodos personalizados - Ligero: modelo de 4B de parámetros, adecuado para GPUs de consumo
Casos de uso
Qwen3.5 destaca en escenarios donde combinar la comprensión visual con la generación de texto aporta valor a un flujo de trabajo de ComfyUI:- Ingeniería inversa de prompts a partir de una imagen: dale una imagen de referencia a Qwen3.5 y pídele que genere un prompt de texto detallado que pueda reproducir esa imagen. Resulta especialmente útil cuando encuentras una gran imagen pero no sabes con qué prompt se generó.
- Optimización de prompts: carga un prompt existente y un concepto de imagen, y luego pide a Qwen3.5 que genere, refine o expanda prompts con mayor detalle para obtener mejores resultados de generación.
- Generación de descripciones de imágenes: genera automáticamente leyendas, descripciones o etiquetas de metadatos para las imágenes generadas, lo que resulta útil para catalogar o preparar datos de entrenamiento.
- Respuesta a preguntas sobre imágenes: haz preguntas acerca del contenido de la imagen (“¿Qué objetos hay en esta escena?”, “¿De qué color es el fondo?”) y obtén respuestas de texto estructuradas.
- Lectura de texto: con un prompt adecuado, el modelo puede intentar leer el texto visible o las etiquetas de las imágenes, aunque la fiabilidad depende de la calidad y la claridad del texto renderizado.
Flujo de trabajo disponible
Qwen3.5: Text Generation
Usa el modelo Qwen3.5 para analizar una imagen de entrada y generar prompts descriptivos de texto. Este flujo de trabajo realiza descripción de imágenes e ingeniería inversa de prompts.
Ejecutar en Comfy Cloud
Abrir en Comfy Cloud
Descargar flujo de trabajo
Descarga el JSON o busca “Qwen3.5: Text Generation” en la biblioteca de plantillas
LoadImage correspondiente:
man_with_red_hat.png
Nodo
LoadImage 2 · man_with_red_hat.png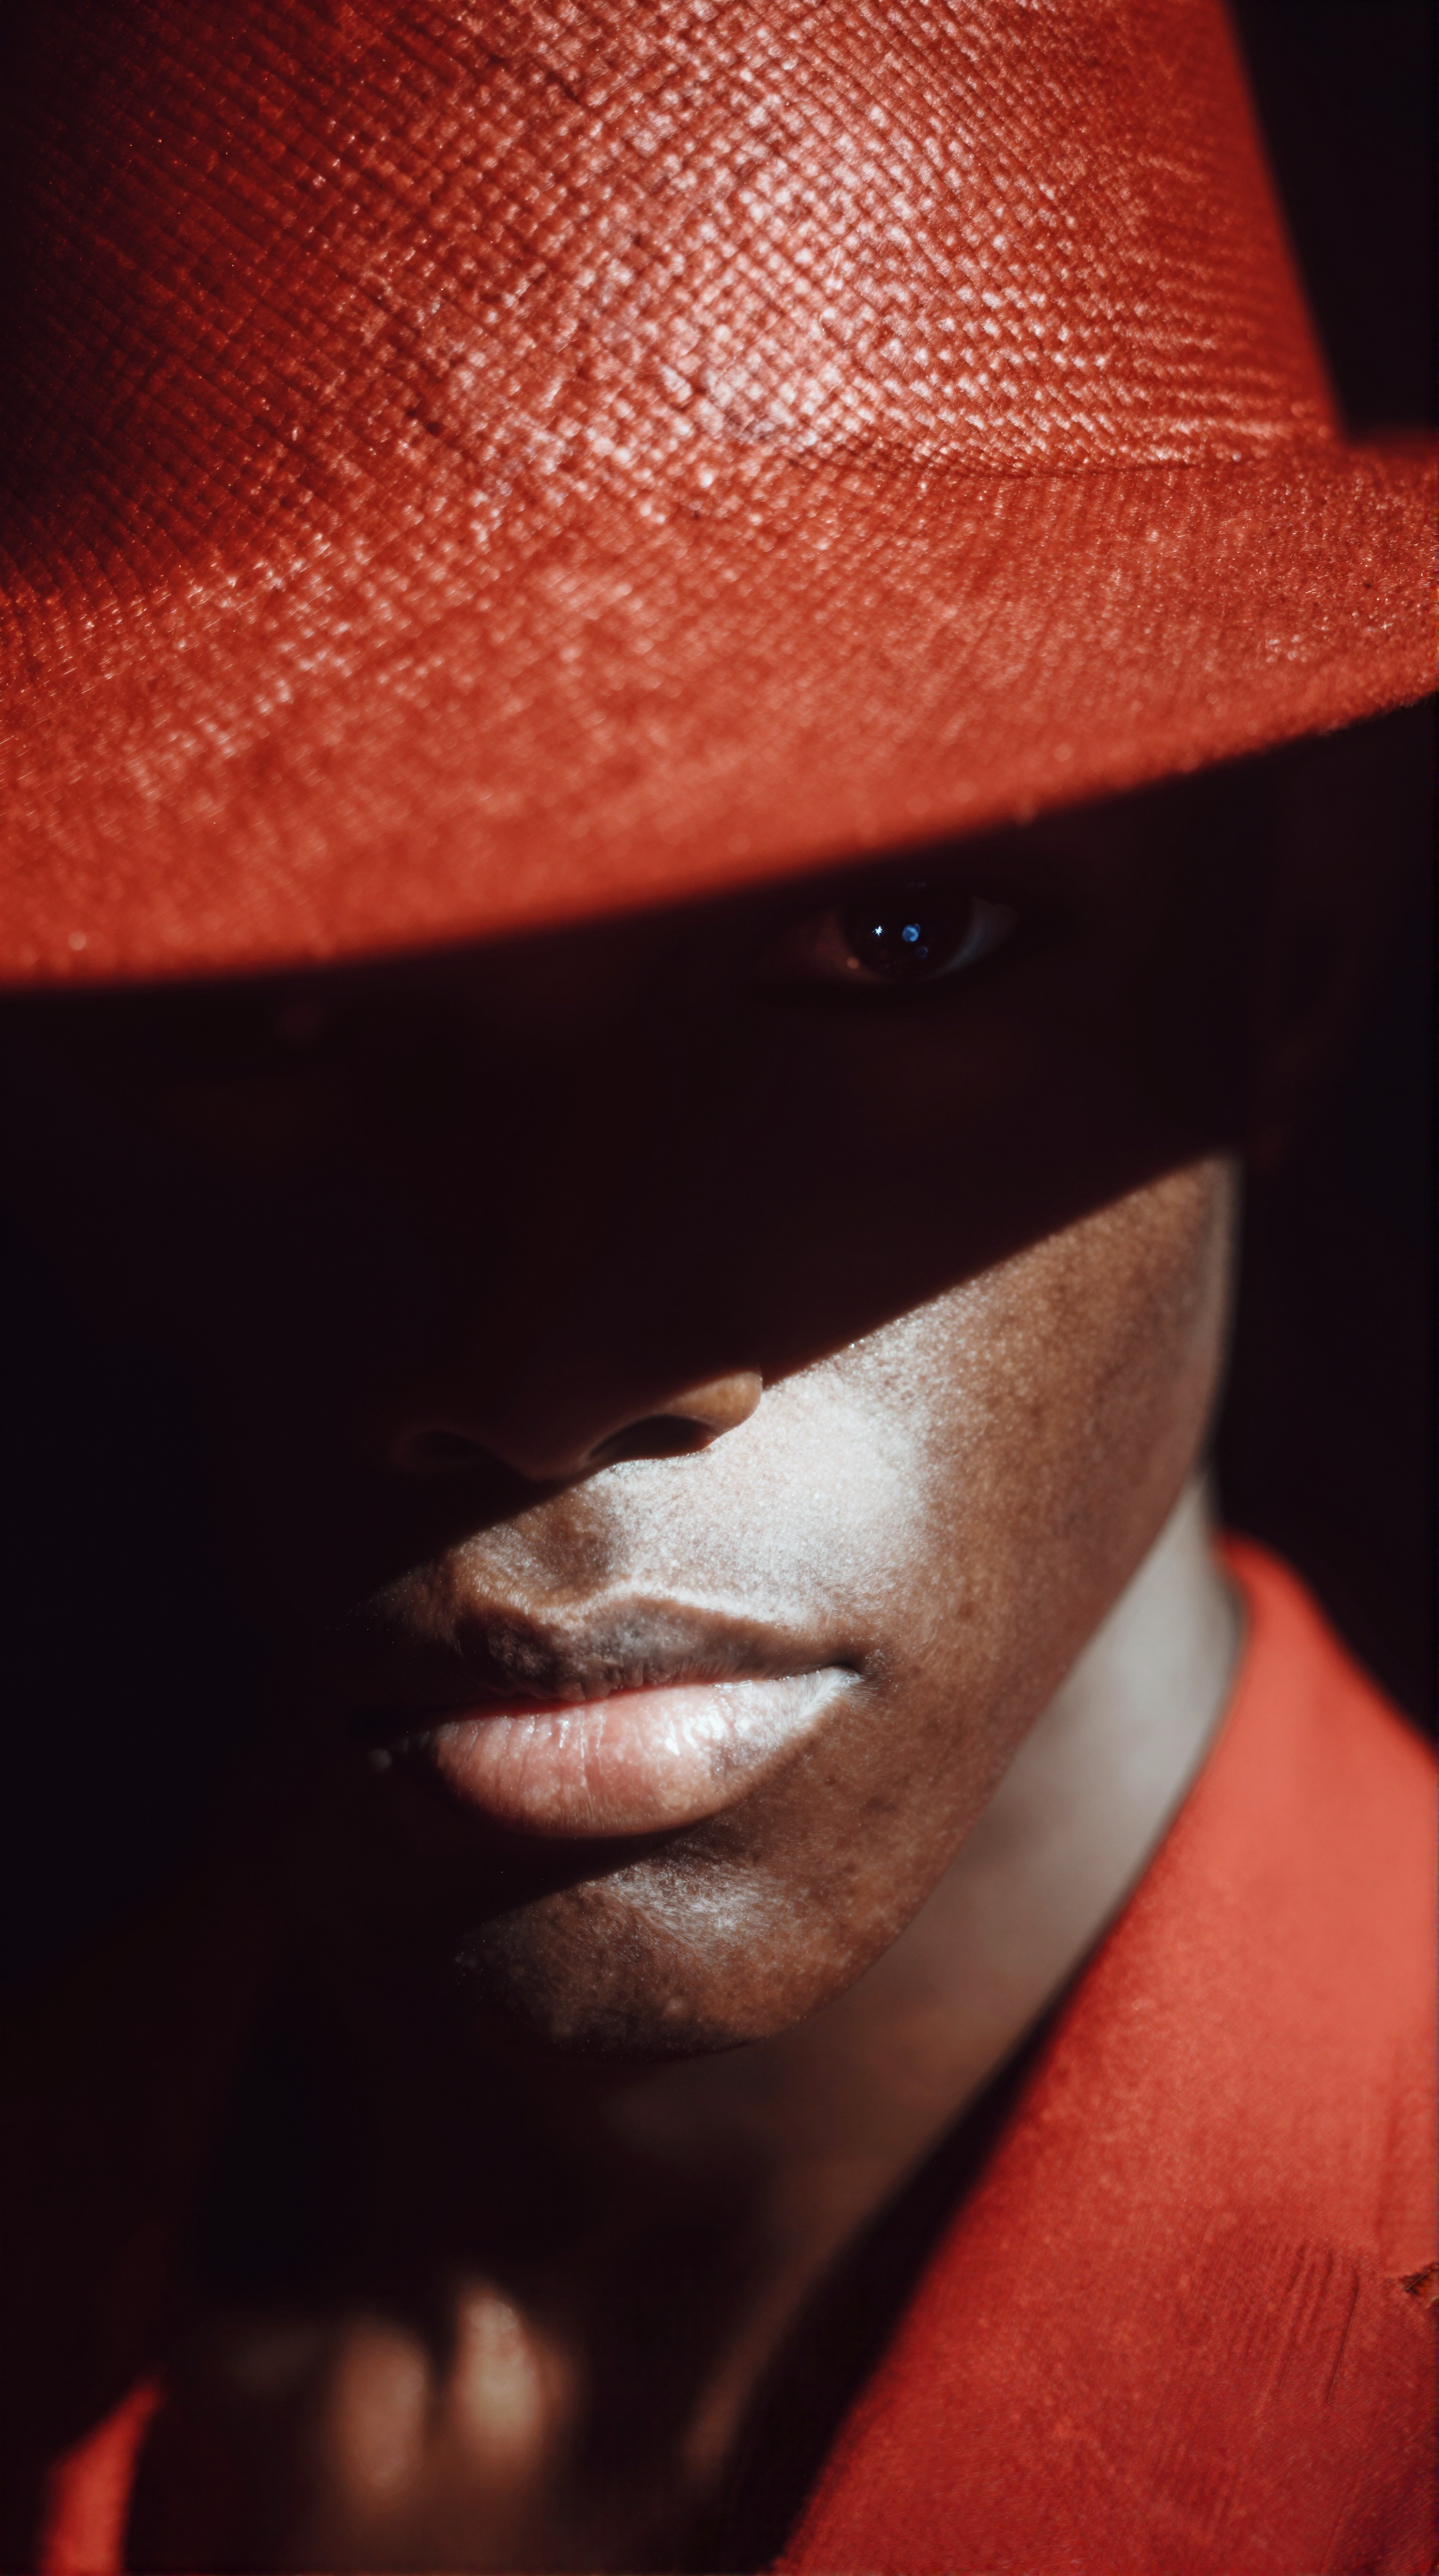
- Prompt de texto: tu pregunta, instrucción o descripción de la tarea
- Imagen (opcional): para tareas de comprensión visual (descripción de imágenes, ingeniería inversa de prompts, optimización de prompts, etc.)
- Max length: número máximo de tokens a generar (256 por defecto)
- Sampling mode: activa o desactiva el muestreo y ajusta temperature, top-k, top-p, repetition penalty y semilla
- Use default template: aplica el prompt de sistema integrado del modelo
- Texto generado: la respuesta del modelo como una cadena de texto plano
Acerca de Subgraph
Este flujo de trabajo usa nodos Subgraph para un procesamiento modular. Consulta la documentación de Subgraph para saber cómo personalizar y ampliar el flujo de trabajo.
Descarga del modelo
Los modelos Qwen3.5 se cargan como text encoders en ComfyUI. Elige la variante que mejor se adapte a tu hardware:Qwen3.5 2B (bf16)
Ligero, ~4.5 GB. Ideal para configuraciones con poca VRAM y descargas rápidas.
Qwen3.5 4B (bf16)
Tamaño y calidad equilibrados. RECOMENDADO para la mayoría de las GPU de consumo.
Qwen3.5 9B (bf16)
La variante más grande, ~19 GB. Mayor calidad de salida, requiere más VRAM.
.safetensors descargado en: