

Kling 3.0의 강점
- 멀티샷 생성: 단일 생성에서 재생 시간 제어를 통해 여러 샷을 생성
- 고정 피사체 일관성: 카메라 움직임과 장면 전개 전반에 걸쳐 캐릭터와 객체의 정체성 유지
- 캐릭터 인식 네이티브 오디오: 정밀한 립싱크와 표정 정렬을 갖춘 다국어 대화
- 네이티브 텍스트 렌더링: 광고, UI 장면, 브랜드 콘텐츠를 위한 선명하고 구조화된 화면 텍스트
출력 예시
Kling 3.0 모델을 사용한 텍스트 기반 이미지 생성: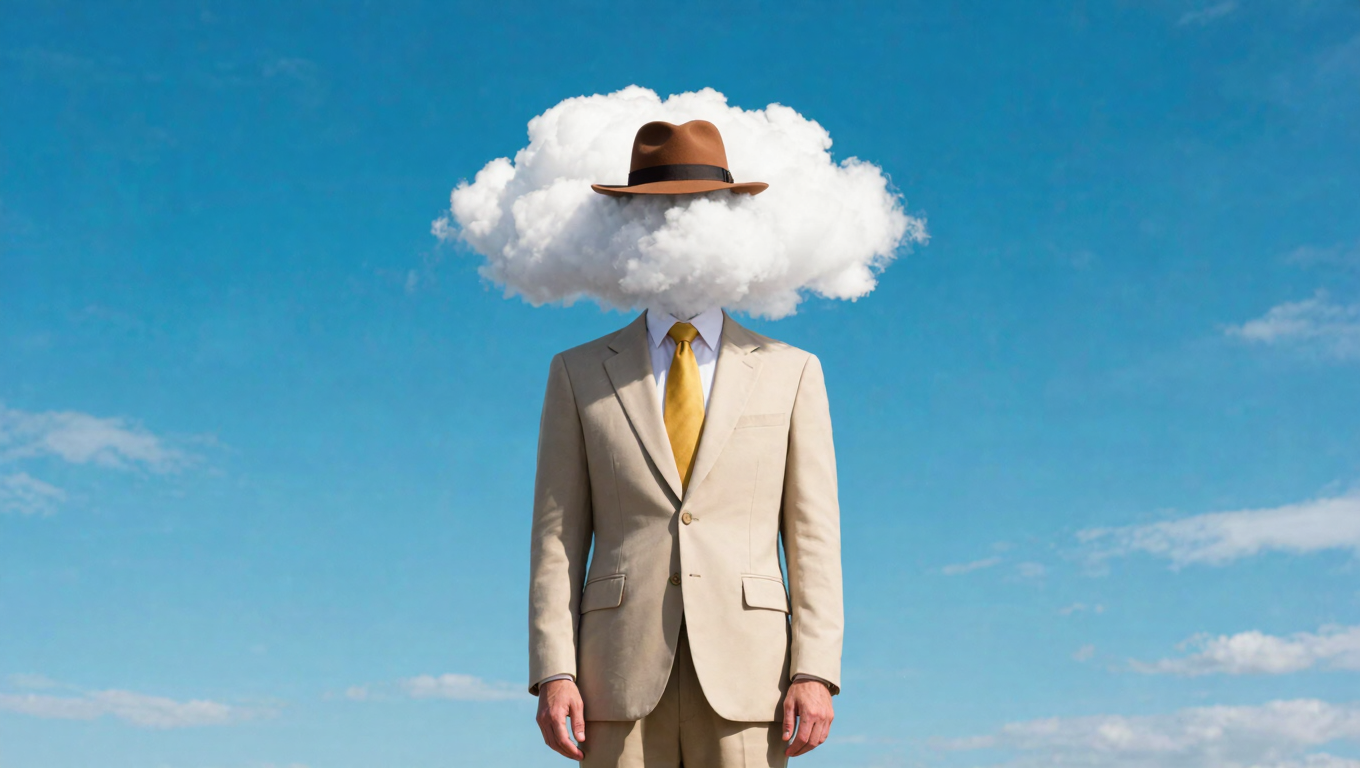
제공되는 모델
자세히 알아보기
Kling 3.0의 세부적인 예시, 프롬프트, 동영상 시연을 확인하려면 저희 블로그 게시물을 참조하세요:Kling 3.0 모델 출시
동영상 예시, 프롬프트 팁, 기능 상세 분석과 함께 공식 발표 전문을 읽어보세요.
Kling 3.0: 텍스트 기반 이미지 생성
Kling 3.0 모델을 사용하여 텍스트 프롬프트에서 이미지를 생성합니다.
Comfy Cloud에서 실행
Comfy Cloud에서 열기
워크플로 다운로드
JSON 다운로드 또는 템플릿 라이브러리에서 “Kling 3.0: Text to Image” 검색
Kling 3.0: 비디오 생성
텍스트 또는 이미지 프롬프트를 입력하여 멀티 샷 구성, 복잡한 카메라 움직임, 일관된 피사체가 포함된 15초 비디오 시퀀스를 생성하세요.
Comfy Cloud에서 실행
Comfy Cloud에서 열기
워크플로 다운로드
JSON 다운로드 또는 템플릿 라이브러리에서 “Kling 3.0: 비디오 생성” 검색
LoadImage 노드에 업로드하세요:
boxing.png
LoadImage 노드 1 · boxing.png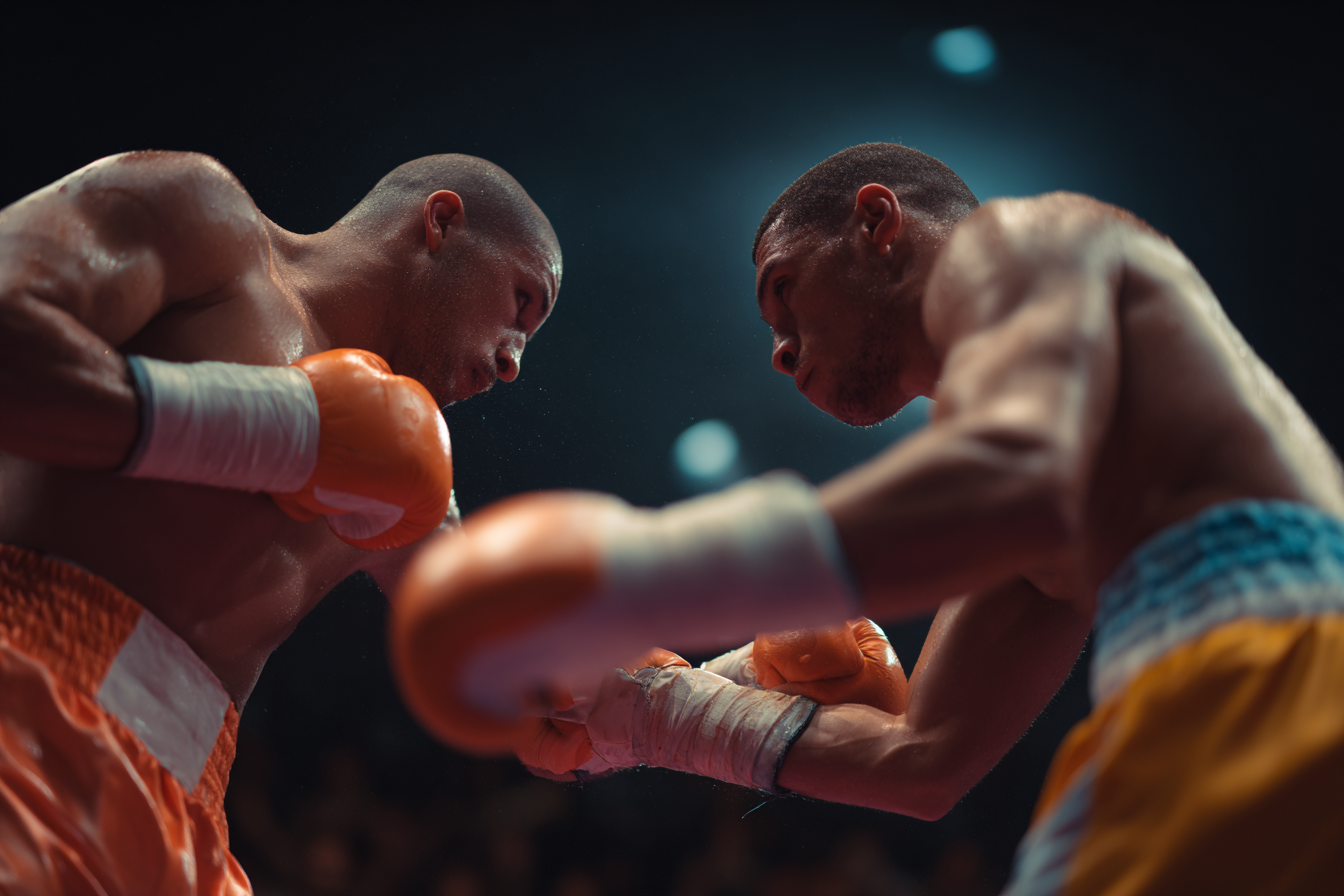
Kling 3.0: 첫 번째 및 마지막 프레임으로 비디오 생성
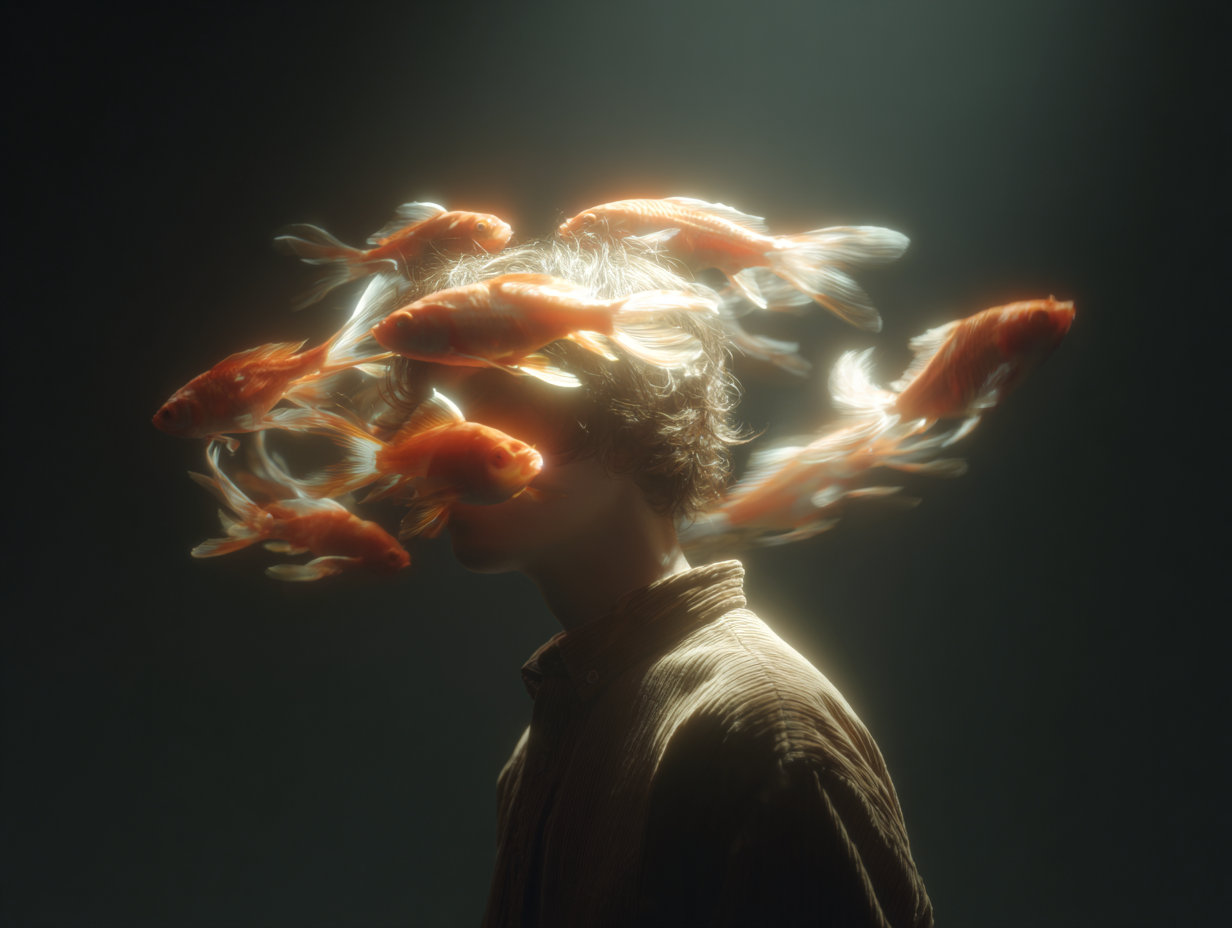
첫 번째 프레임과 마지막 프레임 이미지를 입력하여 멀티샷 생성과 정밀한 요소 제어로 연속적인 비디오 시퀀스를 생성합니다.
Comfy Cloud에서 실행
Comfy Cloud에서 열기
워크플로 다운로드
JSON 다운로드 또는 템플릿 라이브러리에서 “Kling 3.0: First Last Frame to Video” 검색
LoadImage 노드에 업로드하세요:
goldenfish_in_bag.png
LoadImage 노드 1 · goldenfish_in_bag.pngman_in_daydream.png
LoadImage 노드 13 · man_in_daydream.png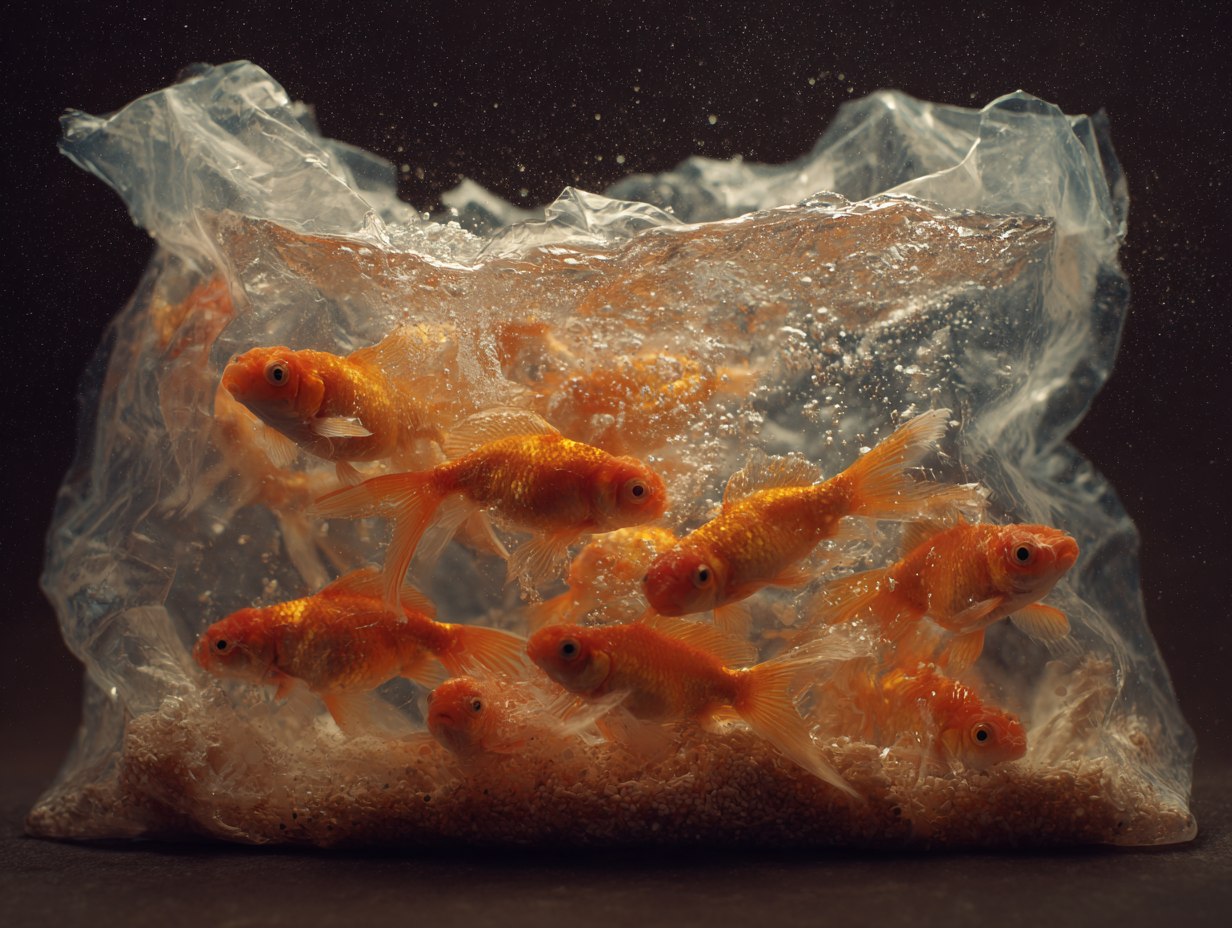
Kling 3.0: 모션 컨트롤
참조 영상의 동작을 캐릭터 이미지에 적용합니다. 캐릭터 이미지와 모션 참조 영상을 업로드하면 모델이 영상 속 동작을 캐릭터에 그대로 옮기면서 캐릭터의 정체성을 유지합니다. 이 워크플로우는 Kling 3.0 모델을 사용하며, 이전 버전보다 얼굴 일관성이 향상되었습니다.
Comfy Cloud에서 실행
Comfy Cloud에서 열기
워크플로 다운로드
JSON 다운로드 또는 템플릿 라이브러리에서 “Kling 3.0: Motion Control” 검색
LoadImage 및 LoadVideo 노드에 업로드하세요:
future_robot.png
LoadImage 노드 2 · future_robot.pngboxing_man.mp4
LoadVideo 노드 3 · boxing_man.mp4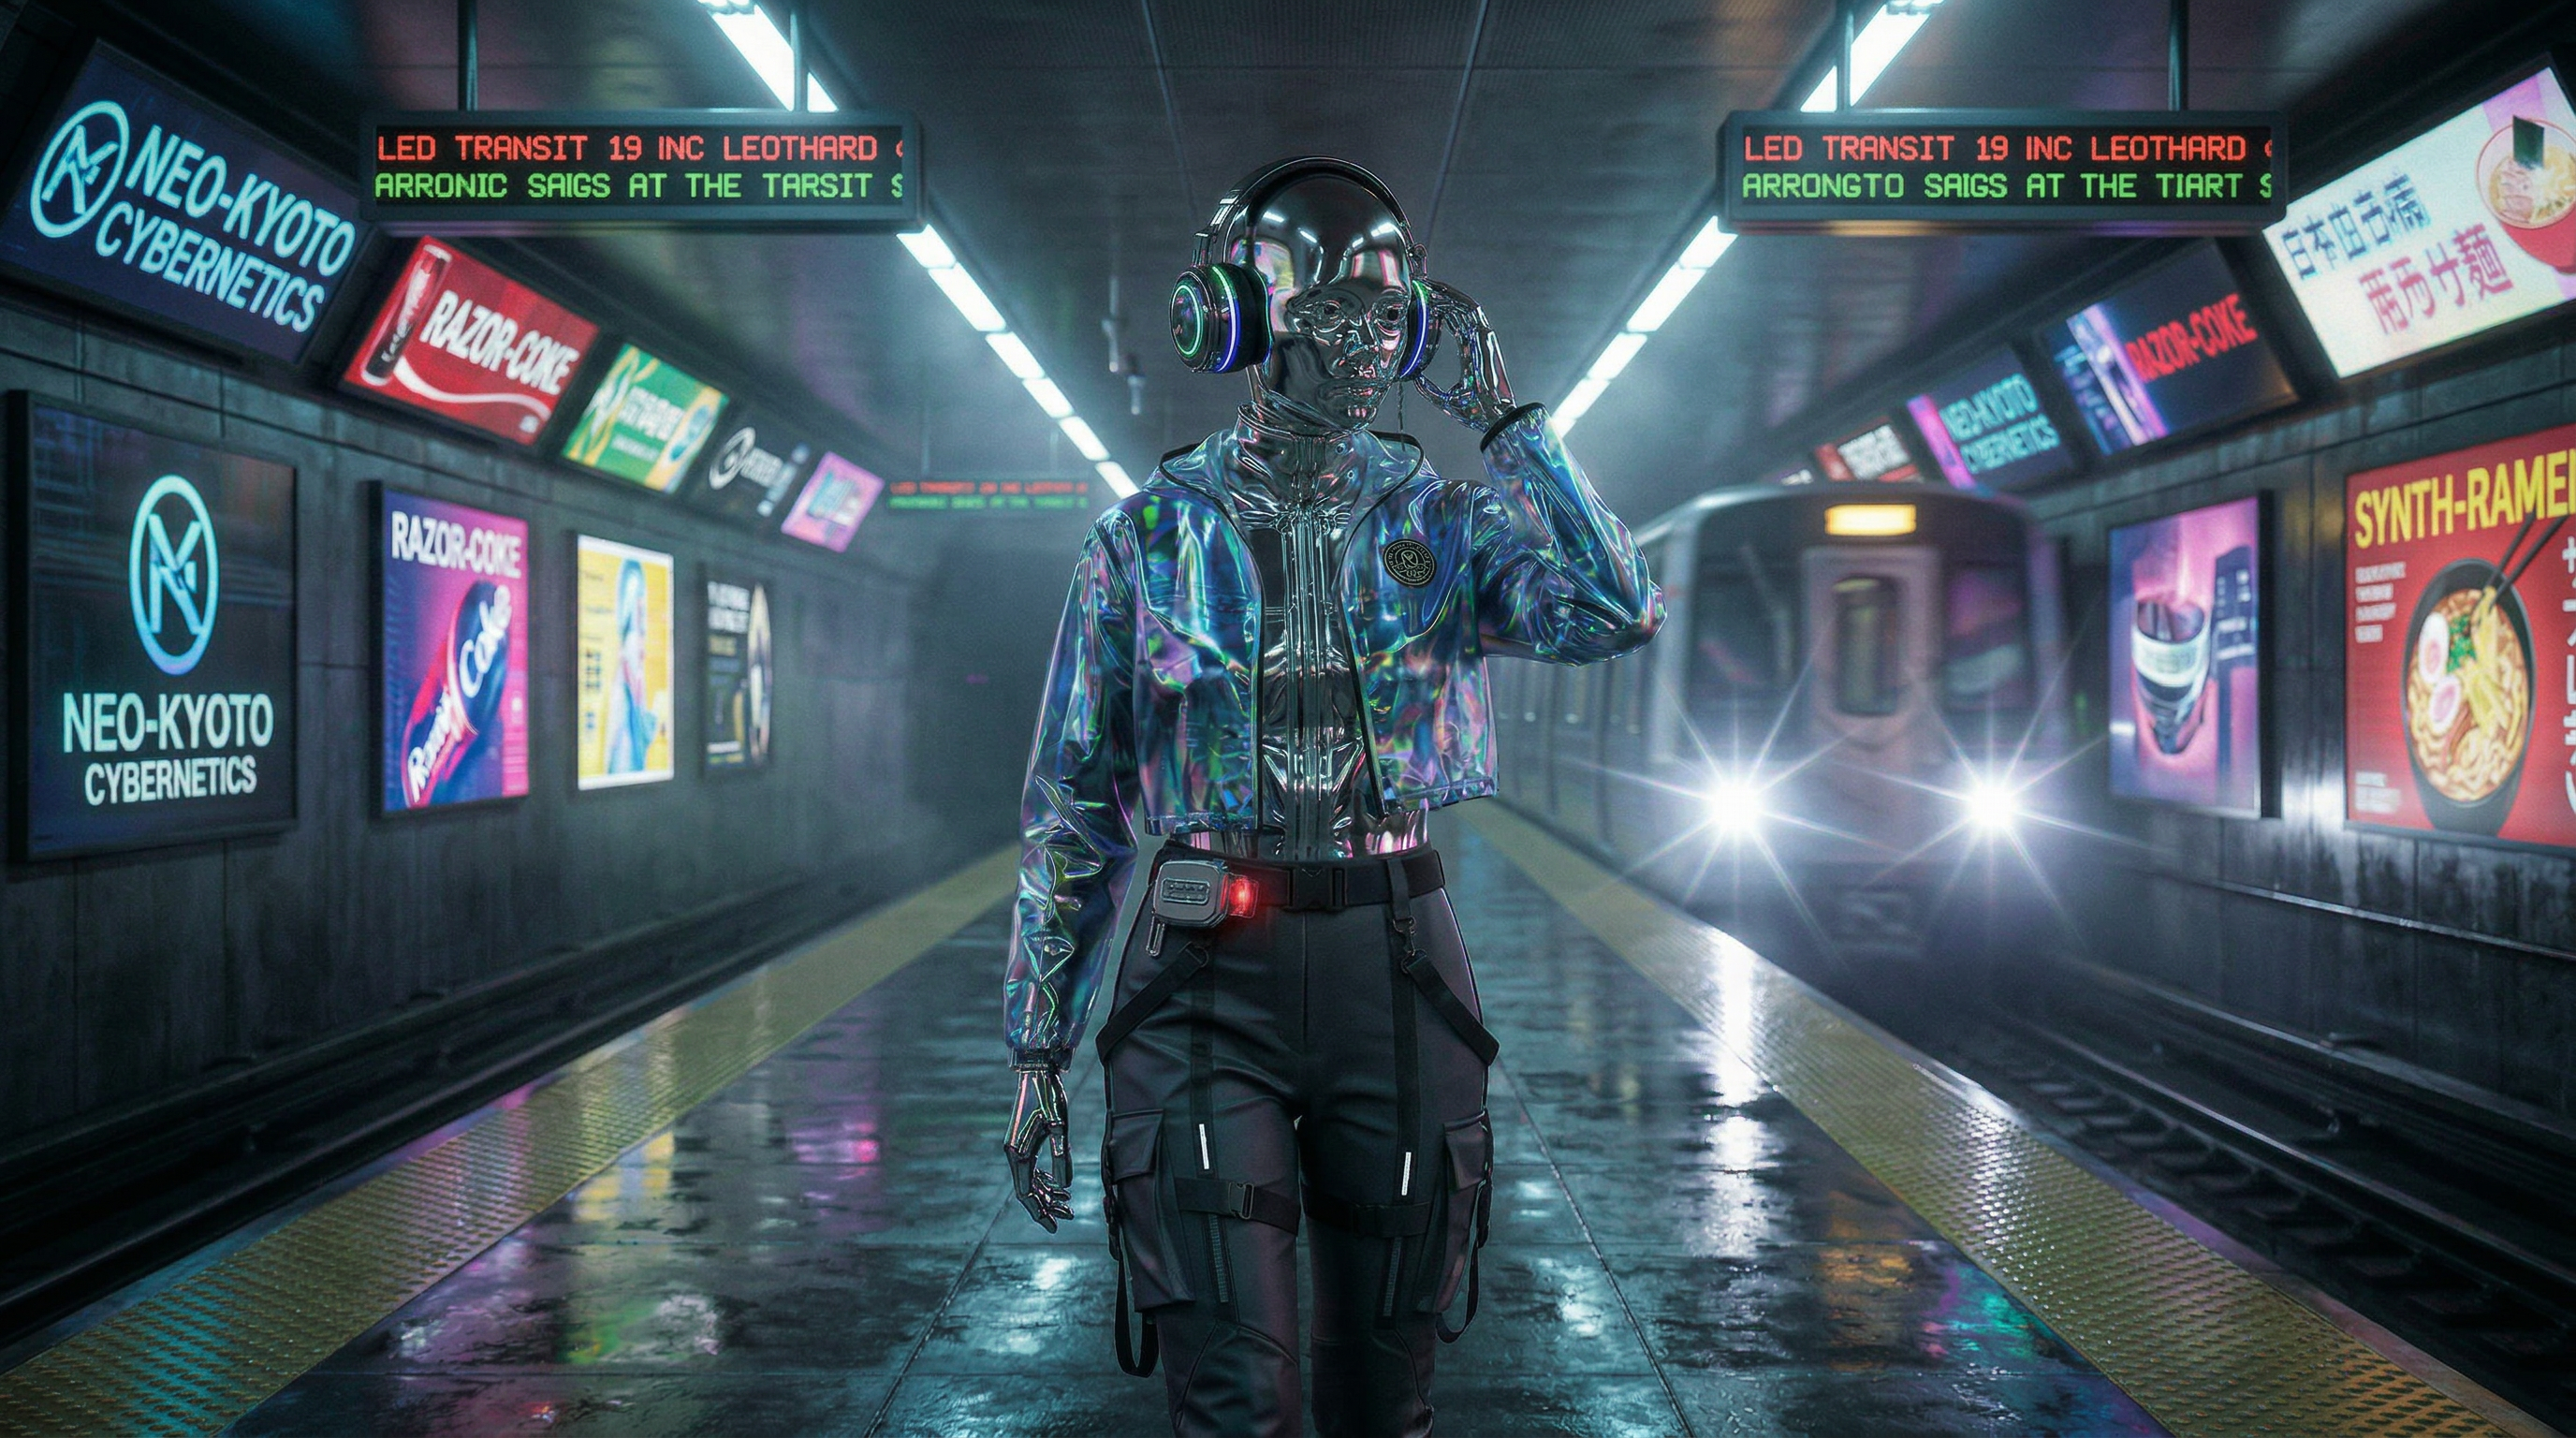
character_orientation을 video로 두세요(참조 영상 최대 30초). 정지 이미지의 구도를 유지하려면 image로 두세요(참조 영상 10초까지). 최종 출력에서는 mode를 pro로 두고, 비용을 줄인 테스트에서는 std로 바꿉니다. keep_original_sound는 참조 영상의 오디오를 결과에 남기고, model은 이전 세대인 kling-v2-6으로 바꿀 수 있습니다.
이 워크플로우는 Kling 2.6 모션 컨트롤 예시와 동일한 Kling Motion Control 노드를 사용하므로, 해당 페이지의 입력 팁도 그대로 적용됩니다.
레거시 Kling 모델 (EOL)
폐기된 워크플로 템플릿 및 대체안
가상 피팅은 FLUX 가상 피팅 (
api_flux_vto) 또는 다른 지원되는 대안을 사용하세요. FLUX VTO 및 Gemini 기반 패션 템플릿은 이번 폐기 대상이 아닙니다.