

Introducción a OpenPose
OpenPose es un sistema de código abierto para la estimación de pose de varias personas en tiempo real, desarrollado por la Universidad Carnegie Mellon (CMU), que supone un avance significativo en el campo de la visión por computador. El sistema puede detectar simultáneamente a varias personas en una imagen y captura:- Esqueleto corporal: 18 puntos clave, incluidos cabeza, hombros, codos, muñecas, caderas, rodillas y tobillos
- Expresiones faciales: 70 puntos clave faciales para capturar microexpresiones y contornos faciales
- Detalles de la mano: 21 puntos clave de la mano para expresar con precisión la posición de los dedos y los gestos
- Postura de los pies: 6 puntos clave del pie, que registran las posturas al estar de pie y los detalles del movimiento
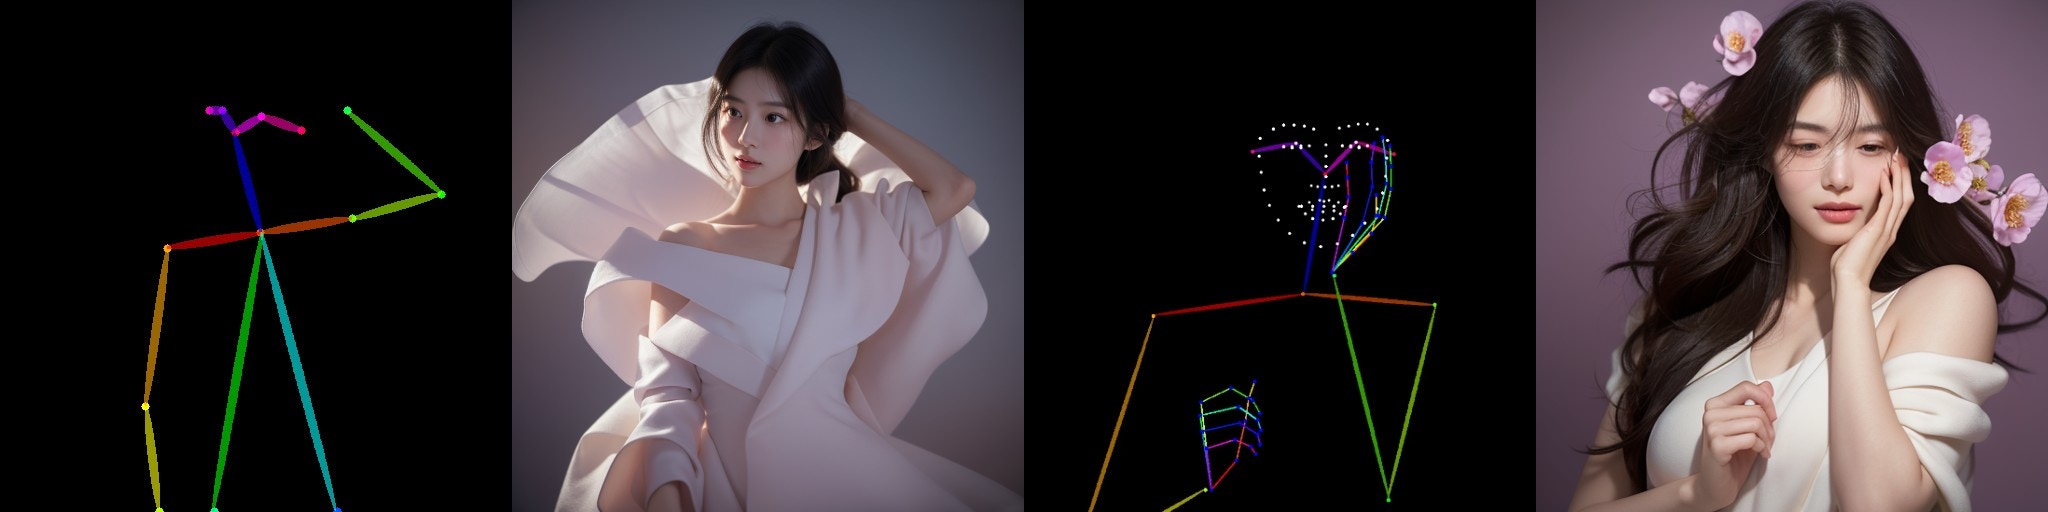
Ejemplo de uso de ControlNet de pose en 2 pasos en ComfyUI
1. Recursos del flujo de trabajo de ControlNet de pose
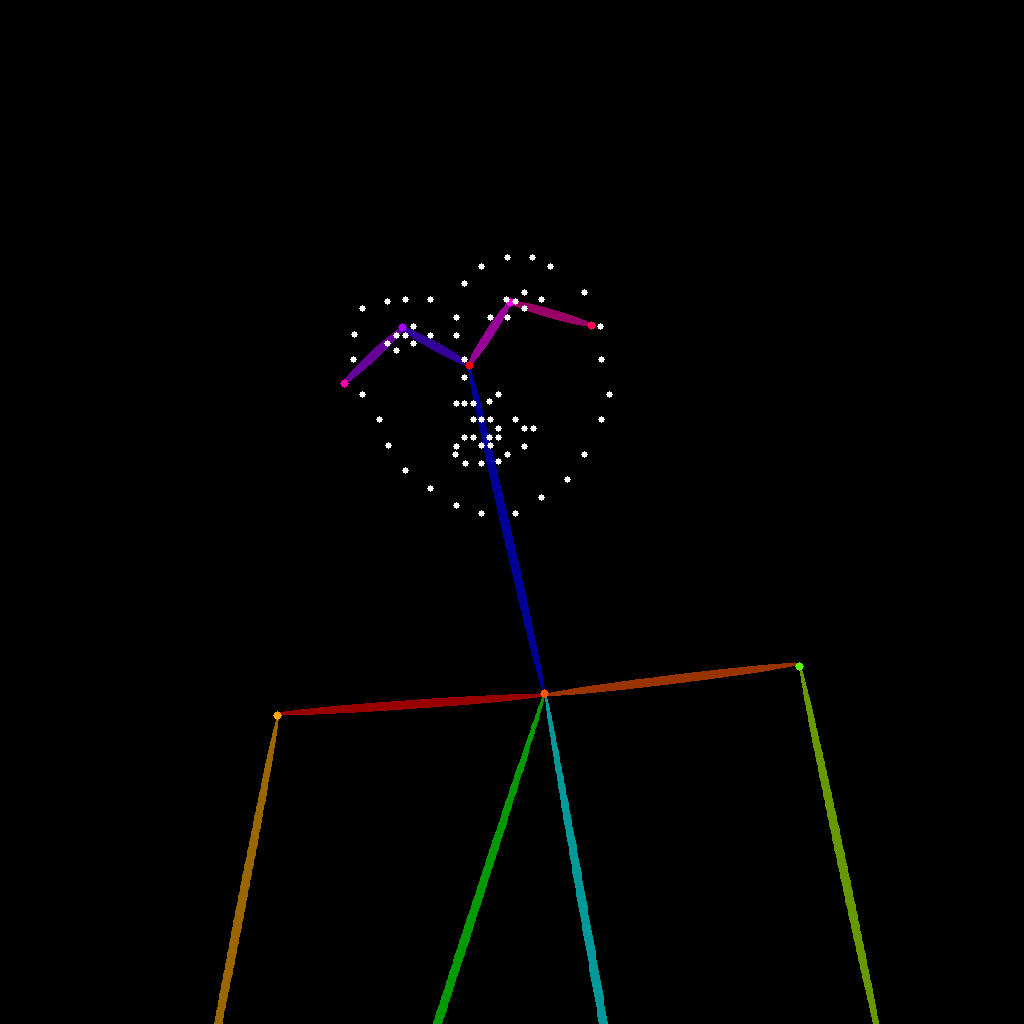
Descarga la imagen del flujo de trabajo que aparece a continuación y arrástrala a ComfyUI para cargar el flujo de trabajo: Descarga la imagen que aparece a continuación, la cual usaremos como entrada:
2. Instalación manual de los modelos
Si tu red no puede completar correctamente la descarga automática de los modelos correspondientes, intenta descargar manualmente los modelos que aparecen a continuación y colócalos en los directorios indicados:
- control_v11p_sd15_openpose_fp16.safetensors
- majicmixRealistic_v7.safetensors
- japaneseStyleRealistic_v20.safetensors
- vae-ft-mse-840000-ema-pruned.safetensors
3. Ejecución del flujo de trabajo paso a paso
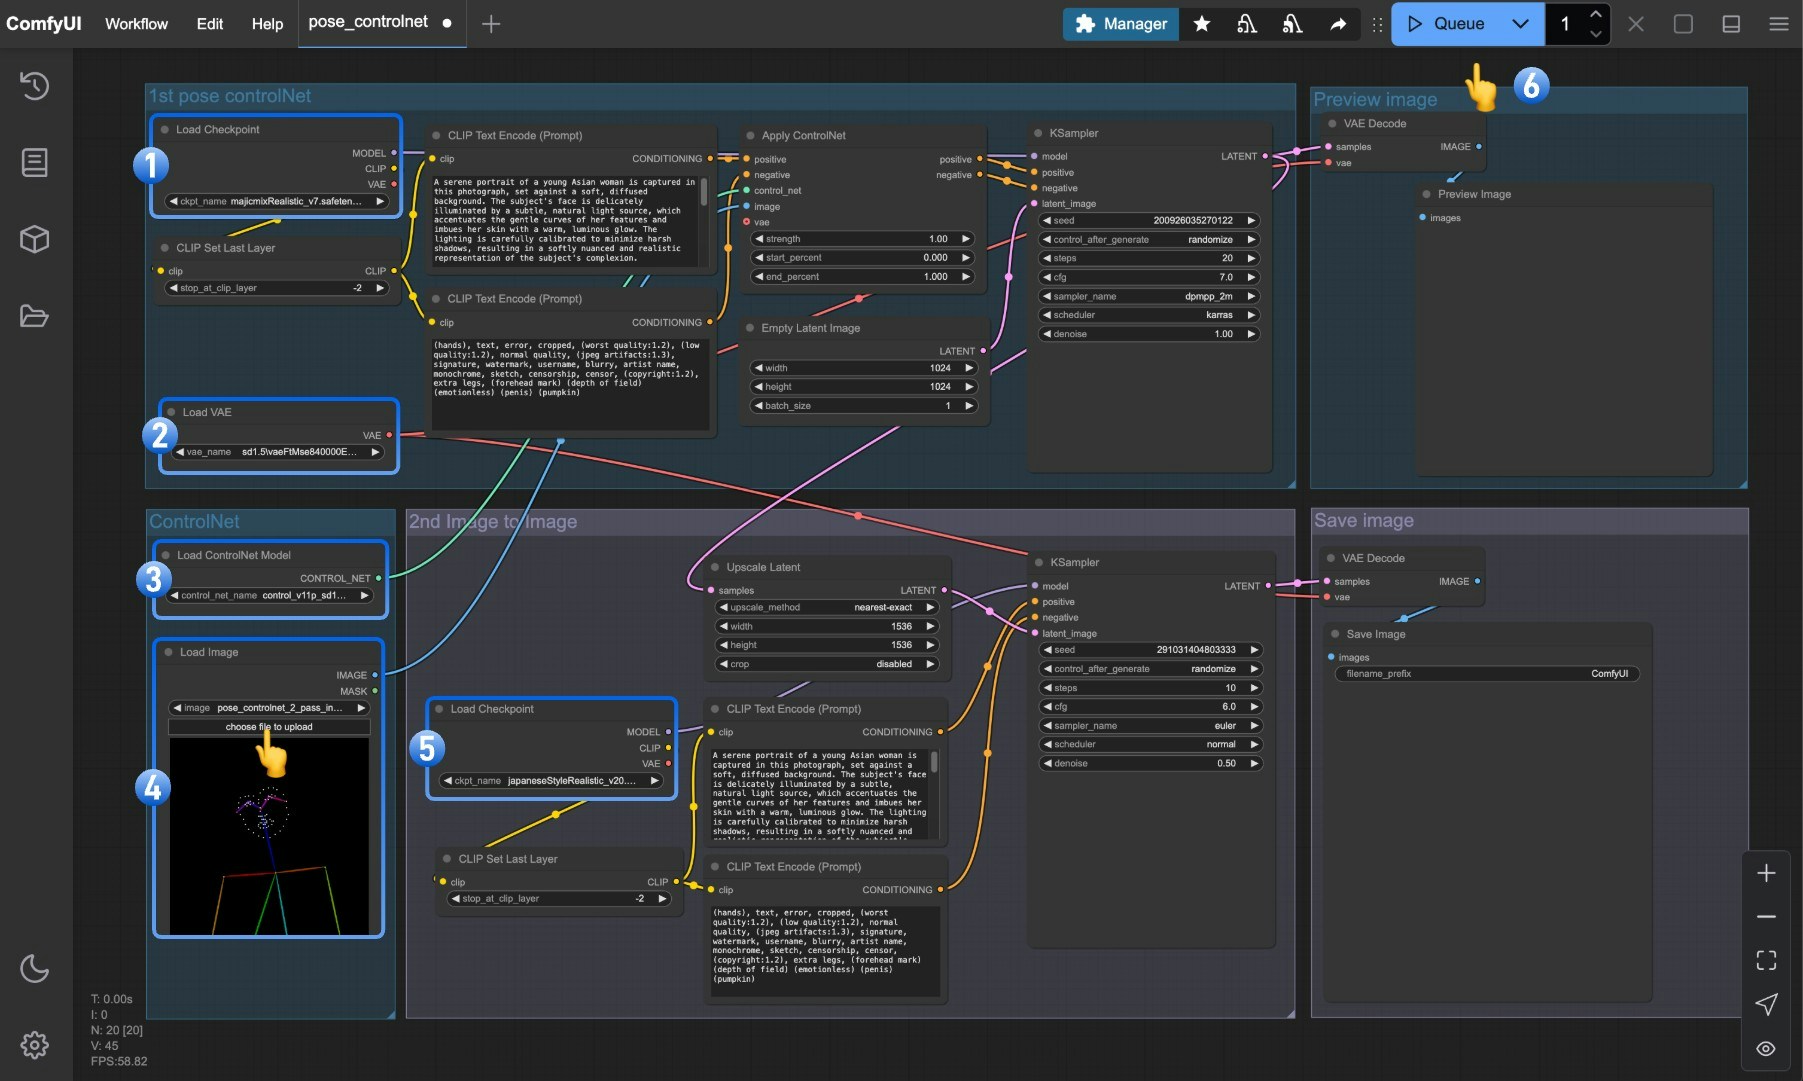
- Asegúrate de que
Load Checkpointpueda cargar majicmixRealistic_v7.safetensors - Asegúrate de que
Load VAEpueda cargar vae-ft-mse-840000-ema-pruned.safetensors - Asegúrate de que
Load ControlNet Modelpueda cargar control_v11p_sd15_openpose_fp16.safetensors - Haz clic en el botón de selección del nodo
Load Imagepara subir la imagen de entrada de pose proporcionada anteriormente, o usa tu propio mapa de esqueleto OpenPose - Asegúrate de que
Load Checkpointpueda cargar japaneseStyleRealistic_v20.safetensors - Haz clic en el botón
Queueo usa el atajoCtrl(cmd) + Enterpara ejecutar la generación de la imagen
Explicación del flujo de trabajo Pose ControlNet en dos pasadas
Este flujo de trabajo usa un enfoque de generación de imágenes en dos pasadas, que divide el proceso de creación de la imagen en dos fases:Primera fase: generación de la imagen básica de la pose
En la primera fase, el modelo majicmixRealistic_v7 se combina con Pose ControlNet para generar una imagen inicial de la pose del personaje:- Primero, carga el modelo majicmixRealistic_v7 mediante el nodo
Load Checkpoint - Carga el modelo de control de pose a través del nodo
Load ControlNet Model - La imagen de pose de entrada se introduce en el nodo
Apply ControlNety se combina con las condiciones de prompt positivo y negativo - El primer nodo
KSampler(normalmente con 20-30 pasos) genera una imagen básica de la pose del personaje - La imagen en espacio de píxeles de la primera fase se obtiene mediante
VAE Decode
Segunda fase: optimización del estilo y mejora de detalles
En la segunda fase, la imagen de salida de la primera fase se usa como referencia, y el modelo japaneseStyleRealistic_v20 realiza la estilización y la mejora de detalles:- La imagen generada en la primera fase crea un espacio latent de mayor resolución mediante el nodo
Upscale latent - El segundo
Load Checkpointcarga el modelo japaneseStyleRealistic_v20, que se centra en los detalles y el estilo - El segundo nodo
KSamplerusa una fuerza dedenoisemás baja (normalmente 0.4-0.6) para el refinado, conservando la estructura básica de la primera fase - Por último, se obtiene una imagen de mayor calidad y resolución mediante los segundos nodos
VAE DecodeySave Image
Ventajas de la generación de imágenes en dos pasadas
En comparación con la generación en una sola pasada, el método de generación de imágenes en dos pasadas ofrece las siguientes ventajas:- Mayor resolución: El procesamiento en dos pasadas puede generar imágenes de alta resolución que superan las capacidades de la generación en una sola pasada.
- Mezcla de estilos: Puede combinar las ventajas de diferentes modelos, como usar un modelo realista en la primera fase y un modelo estilizado en la segunda fase.
- Mejores detalles: La segunda fase puede centrarse en optimizar los detalles sin tener que preocuparse por la estructura general.
- Control preciso: Una vez completado el control de pose en la primera fase, la segunda fase puede centrarse en refinar el estilo y los detalles.
- Menor carga de la GPU: Generar en dos pasadas permite obtener imágenes grandes de alta calidad con recursos limitados de GPU.