

Z-Image (造相) es un modelo de generación de imágenes potente y muy eficiente con 6B parámetros, desarrollado por Tongyi Lab de Alibaba. Utiliza una arquitectura Scalable Single-Stream DiT (S3-DiT) en la que los tokens de texto, los tokens semánticos visuales y los tokens del VAE de imagen se concatenan a nivel de secuencia para formar un único flujo de entrada, maximizando la eficiencia de los parámetros.
Variantes del modelo:
- 🚀 Z-Image-Turbo: una versión destilada que iguala o supera a los principales competidores con solo 8 NFE (Number of Function Evaluations). Ofrece una latencia de inferencia inferior a un segundo en GPUs H800 de clase empresarial y cabe en dispositivos de consumo con 16 GB de VRAM.
- 🧱 Z-Image-Base: el modelo base sin destilar, pensado para el ajuste fino impulsado por la comunidad y el desarrollo personalizado.
- ✍️ Z-Image-Edit: una variante ajustada para tareas de edición de imágenes, con una capacidad notable para seguir instrucciones.
- Calidad fotorrealista: ofrece una sólida generación de imágenes fotorrealistas sin perder una excelente calidad estética
- Renderizado bilingüe preciso de texto: sobresale al renderizar con precisión texto complejo en chino e inglés
- Mejora de prompts y razonamiento: el Prompt Enhancer dota al modelo de capacidades de razonamiento
- Inferencia inferior a un segundo: alcanza una velocidad de generación rápida en el hardware compatible
Flujo de trabajo de texto a imagen de Z-Image-Turbo
Z-Image-Turbo: Text to Image
Un modelo fundacional eficiente de generación de imágenes con Single-Stream Diffusion Transformer; admite inglés y chino.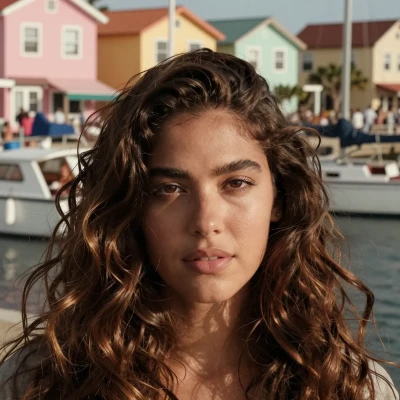
Ejecutar en Comfy Cloud
Ejecuta este flujo de trabajo directamente en Comfy Cloud
Descargar flujo de trabajo
Descarga el archivo JSON del flujo de trabajo de texto a imagen de Z-Image-Turbo
Descargas de modelos de Z-Image-Turbo
qwen_3_4b.safetensors
Codificador de texto para Z-Image-Turbo.
z_image_turbo_bf16.safetensors
Modelo de difusión para Z-Image-Turbo.
ae.safetensors
VAE para Z-Image-Turbo.
Flujo de trabajo de ControlNet Fun Union de Z-Image-Turbo
Z-Image-Turbo Fun Union ControlNet
ControlNet multi-control compatible con Canny, HED, Depth, Pose y MLSD para Z-Image-Turbo.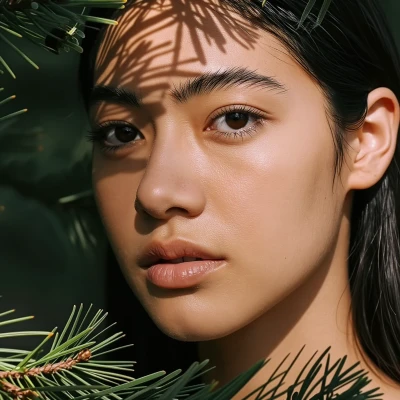
Ejecutar en Comfy Cloud
Ejecuta este flujo de trabajo directamente en Comfy Cloud
Descargar flujo de trabajo
Descarga el archivo JSON del flujo de trabajo de ControlNet Fun Union de Z-Image-Turbo
LoadImage correspondiente:
image_z_image_turbo_fun_union_controlnet_input_image.png
Nodo
LoadImage 58 · image_z_image_turbo_fun_union_controlnet_input_image.png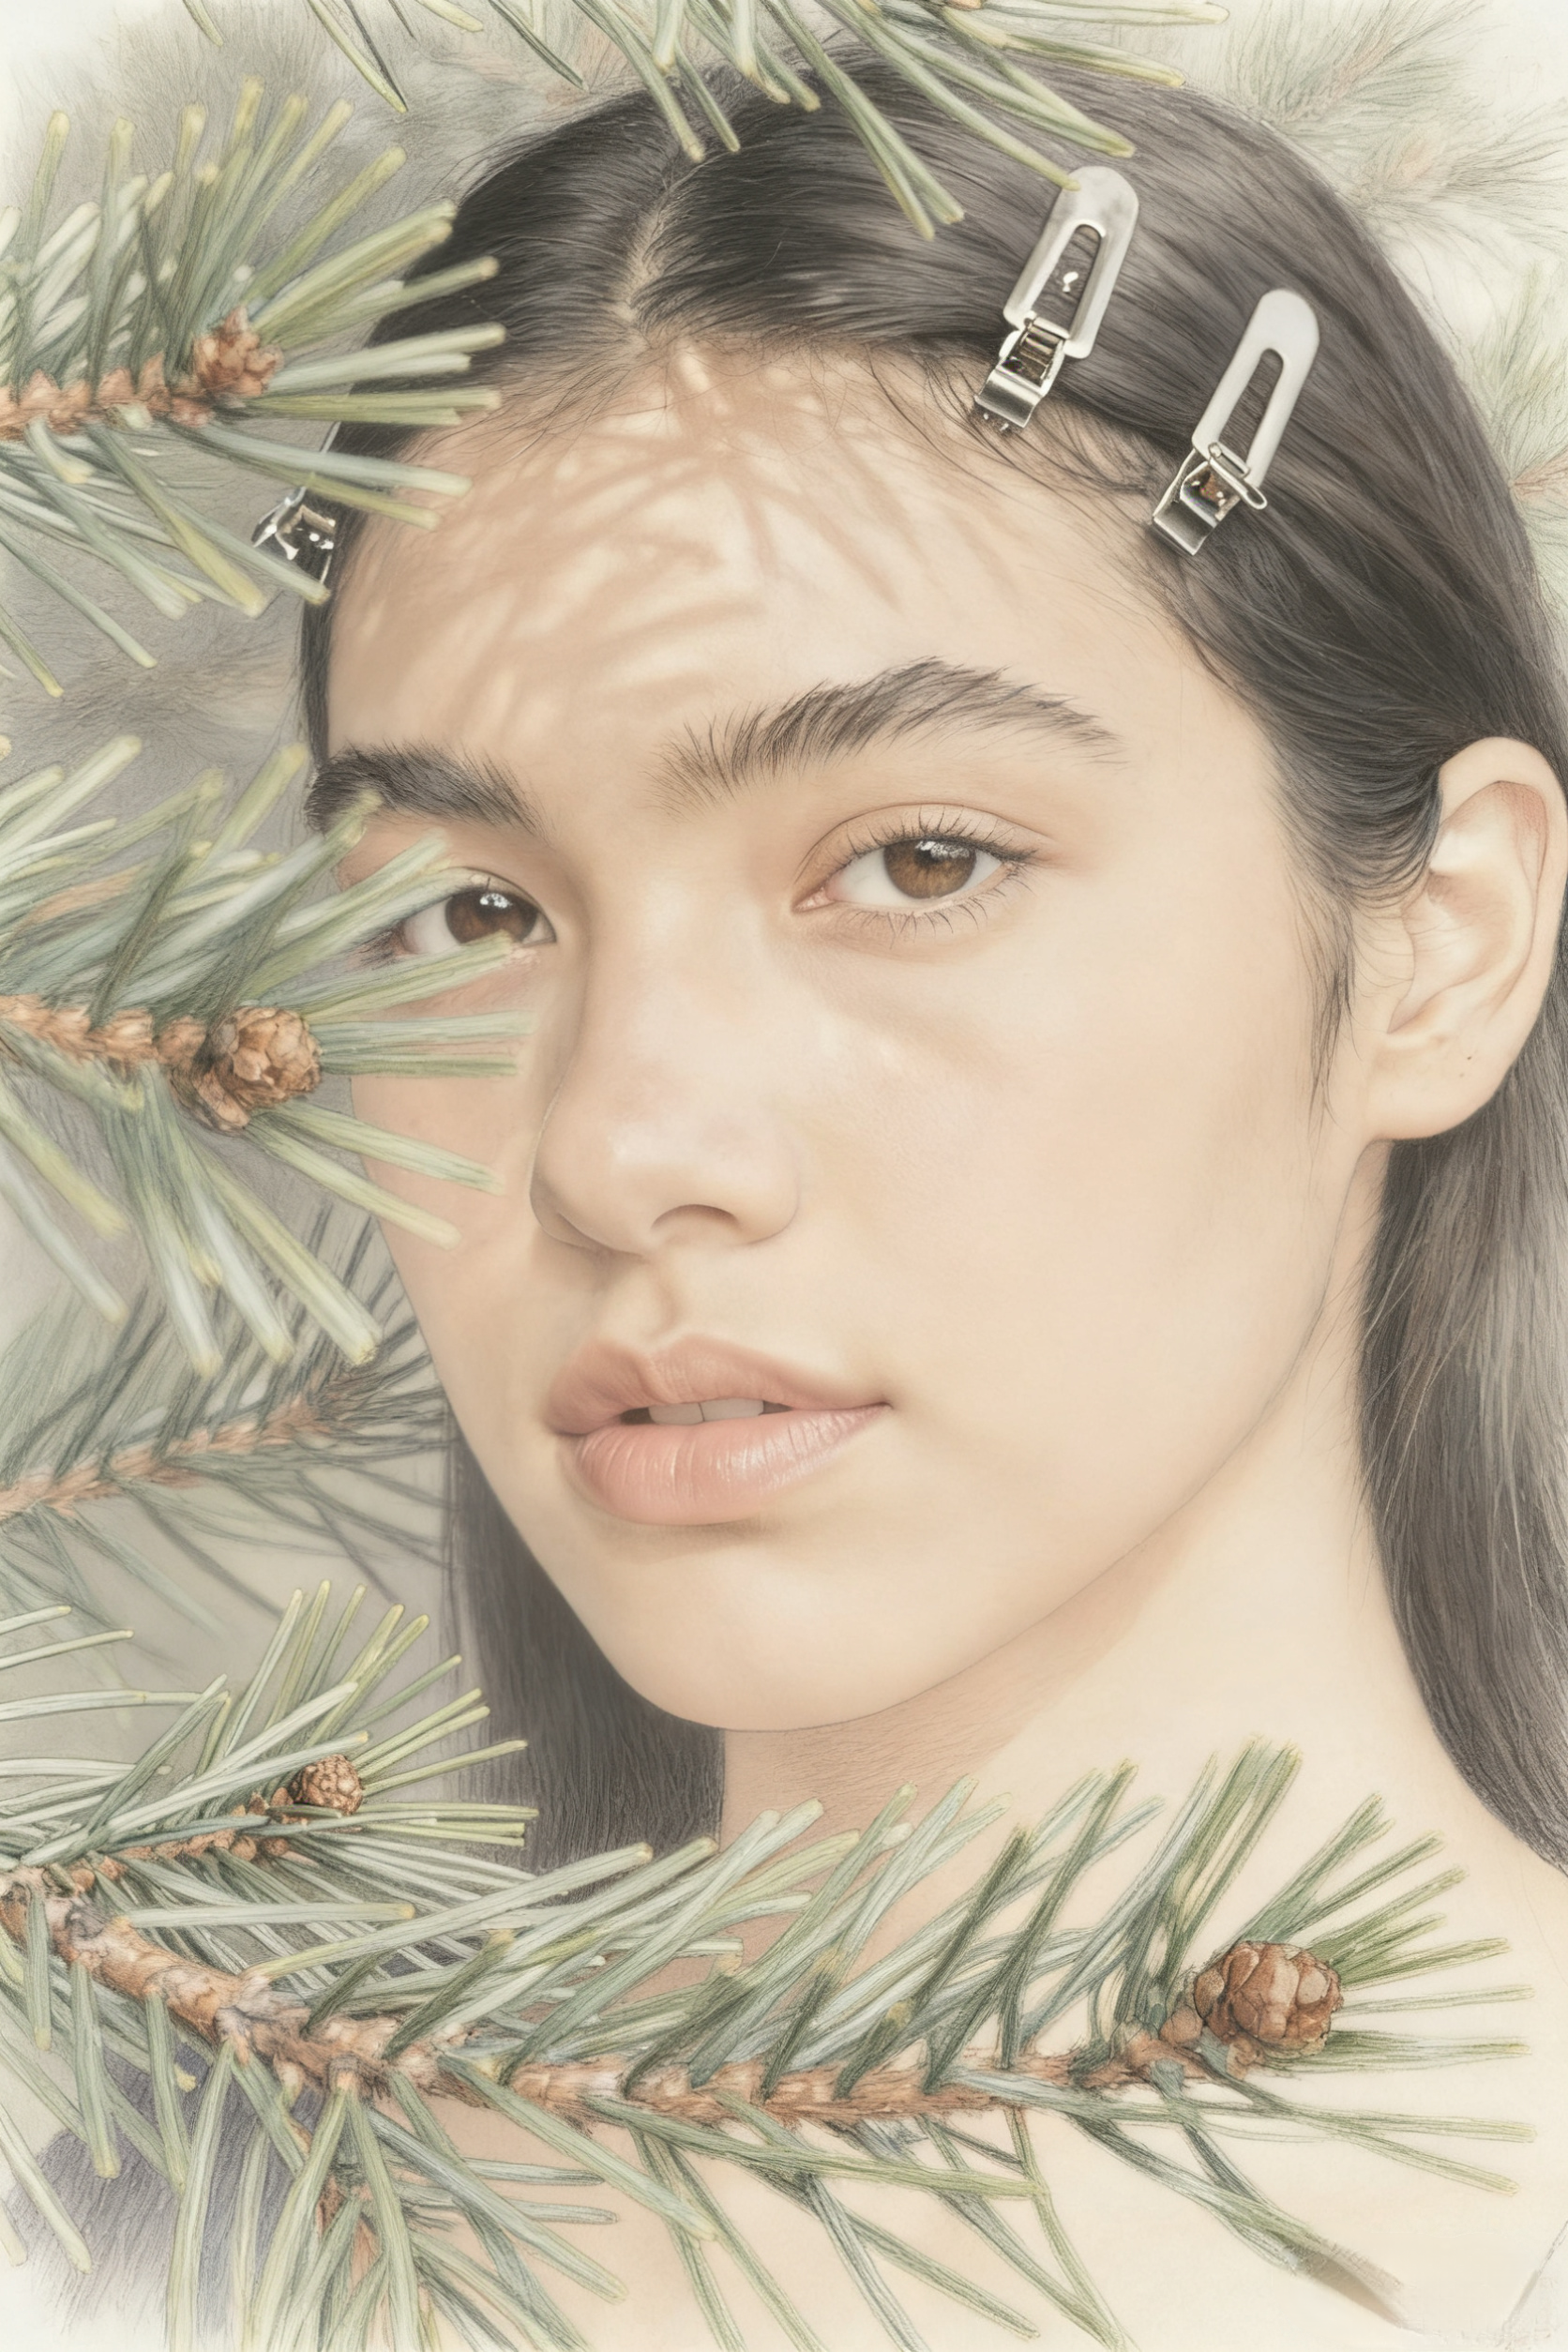
Modelo adicional para ControlNet
Z-Image-Turbo-Fun-Controlnet-Union.safetensors
Parche de modelo ControlNet para Z-Image-Turbo.