

Puntos fuertes
- Keypoints de cuerpo completo: detecta keypoints de cuerpo, manos, rostro y pies en un modelo unificado
- Soporte para varias personas: detecta y etiqueta a varias personas en una sola imagen o video
- Salidas configurables: elige qué partes del cuerpo visualizar (cuerpo, manos, rostro, pies) y controla el tamaño del palo y de la fuente
- Detección de cajas delimitadoras: incluye detección de objetos con umbrales ajustables y selección de clases
- Compatibilidad con imágenes y videos: flujos de trabajo dedicados para imágenes individuales, videos y estimación de pose OOD
Limitaciones: La precisión de la detección depende de la resolución de la imagen y de la visibilidad del sujeto. Los sujetos extremadamente ocluidos o muy pequeños pueden producir menos keypoints.
Flujos de trabajo de SDPose
Hay cuatro flujos de trabajo disponibles según tu caso de uso:1. Descargar flujos de trabajo
Actualiza tu ComfyUI a la última versión, luego ve aWorkflow -> Browse Templates y busca los flujos de trabajo de SDPose en la categoría Utility.
SDPose: detección de varias personas en una imagen
Sube una imagen para detectar poses humanas. Admiten detección tanto para una sola persona como para varias personas dentro de la misma escena.
Ejecutar en Comfy Cloud
Abrir en Comfy Cloud
Descargar flujo de trabajo
Descarga el JSON o busca “SDPose: Image Multi-Person Detection” en la Biblioteca de plantillas
LoadImage correspondiente:
group_photo.png
Nodo
LoadImage 679 · group_photo.png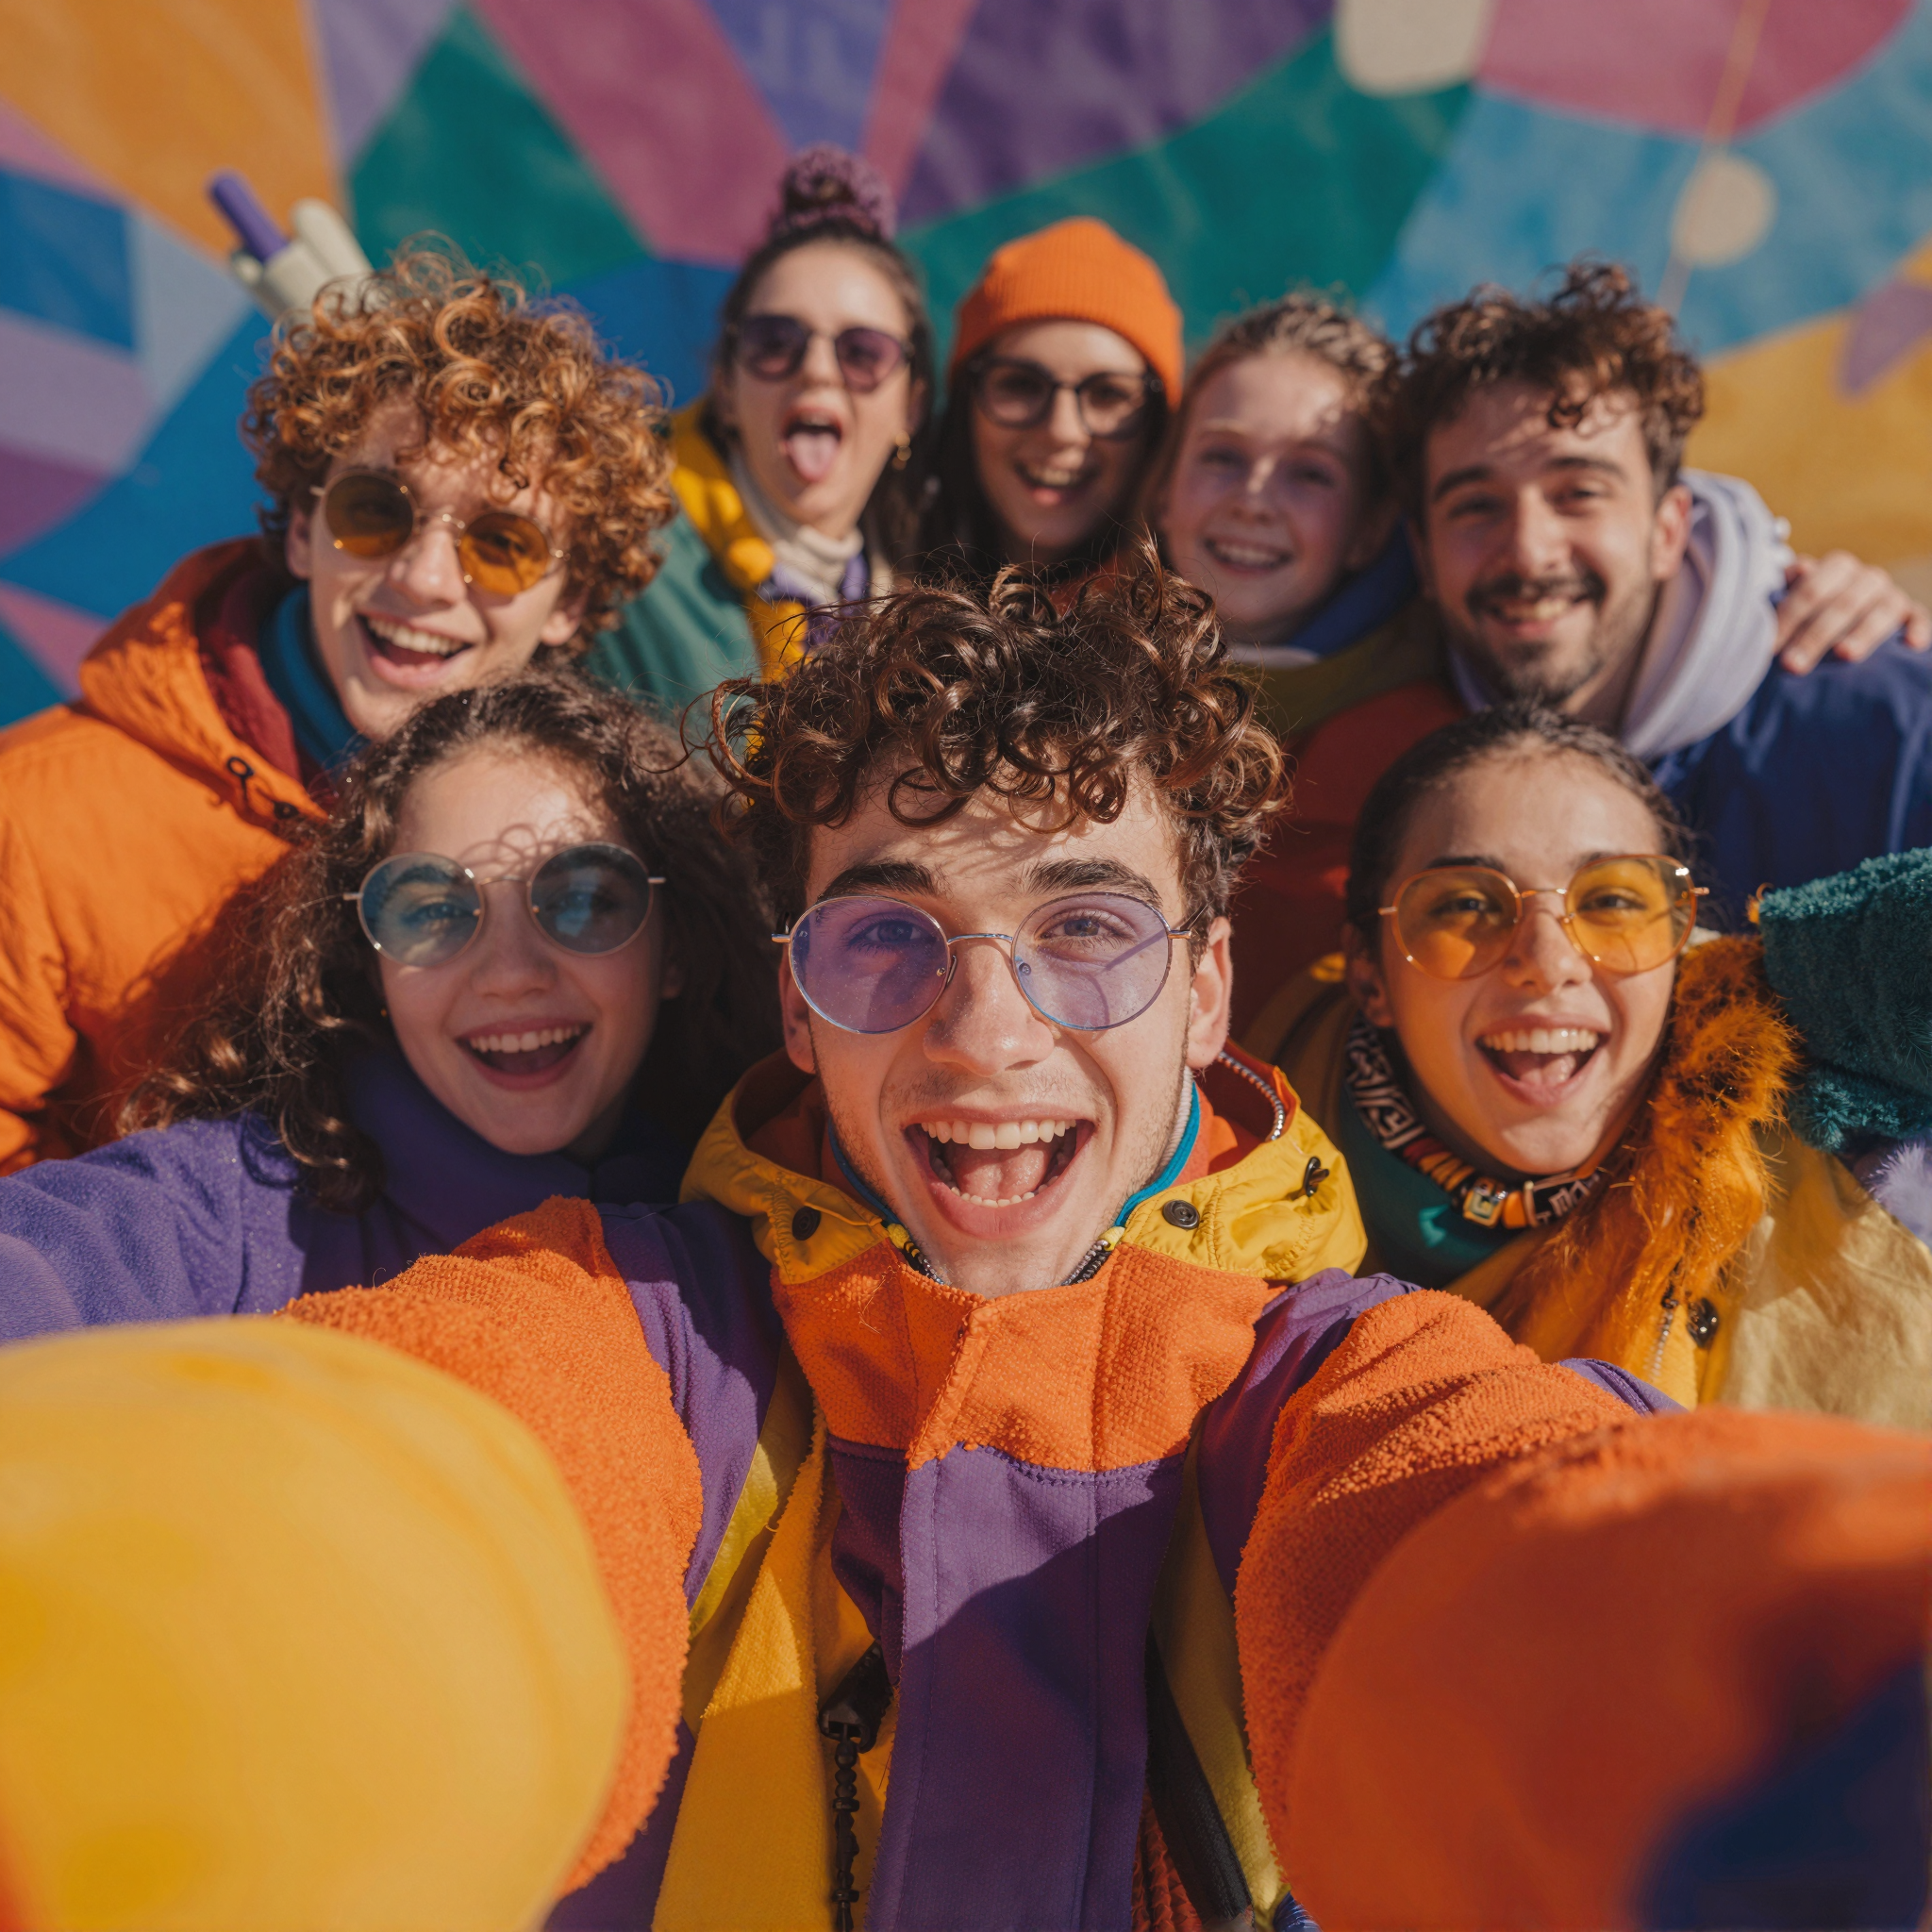
SDPose: detección de varias personas en video
Sube un video para detectar poses humanas. Admite la detección tanto de una sola persona como de varias personas dentro de la misma escena.
Ejecutar en Comfy Cloud
Abrir en Comfy Cloud
Descargar flujo de trabajo
Descarga el JSON o busca “SDPose: Video Multi-Person Detection” en la biblioteca de plantillas
LoadVideo correspondiente:
man_playing_violin.mp4
nodo
LoadVideo 694 · man_playing_violin.mp4SDPose-OOD: de imagen a mapa de pose
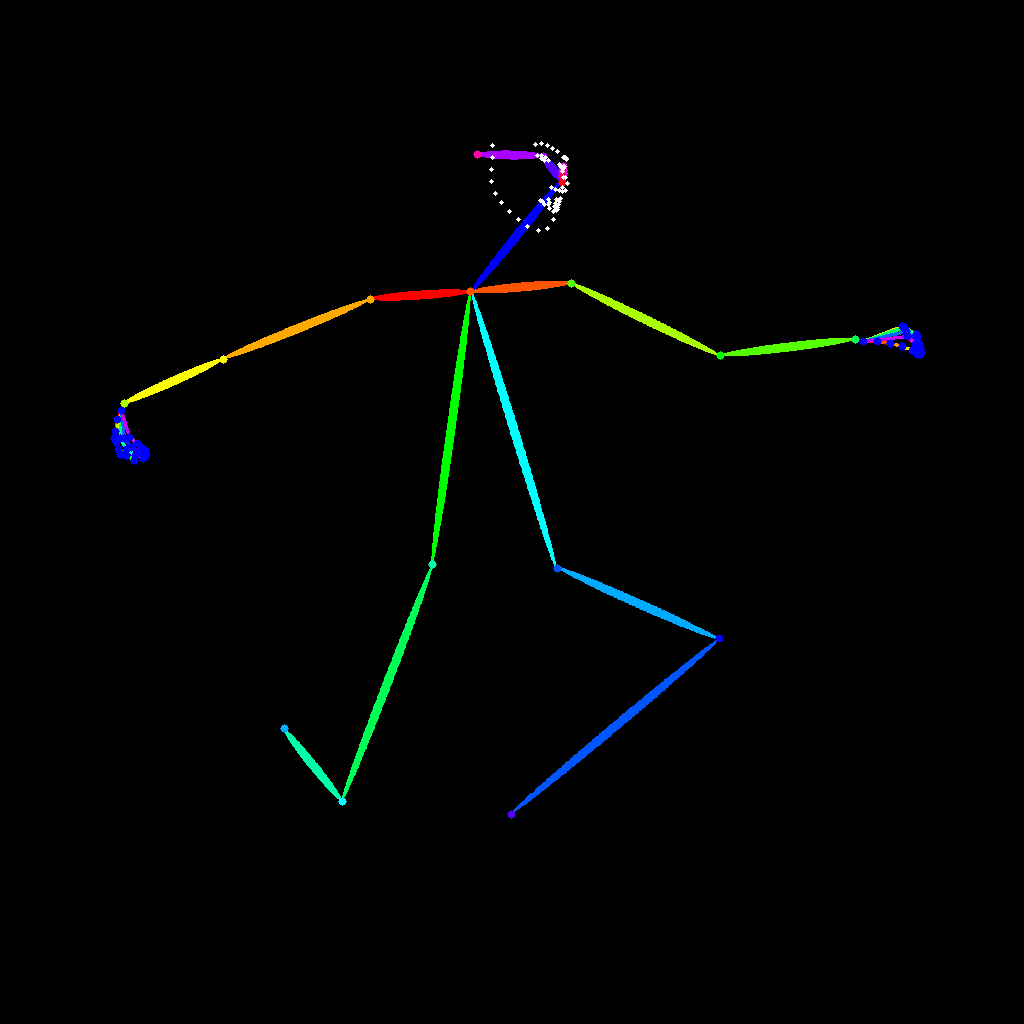
Sube una imagen para extraer los puntos clave de la pose y generar un mapa de pose correspondiente con el modelo SDPose-OOD.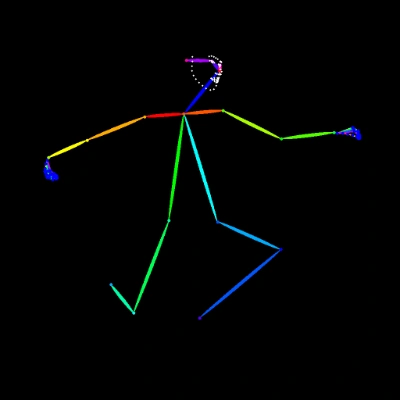
Ejecutar en Comfy Cloud
Abrir en Comfy Cloud
Descargar flujo de trabajo
Descarga el JSON o busca “SDPose-OOD: Image to Pose Map” en la biblioteca de plantillas
LoadImage correspondiente:
dancer.png
Nodo
LoadImage 667 · dancer.png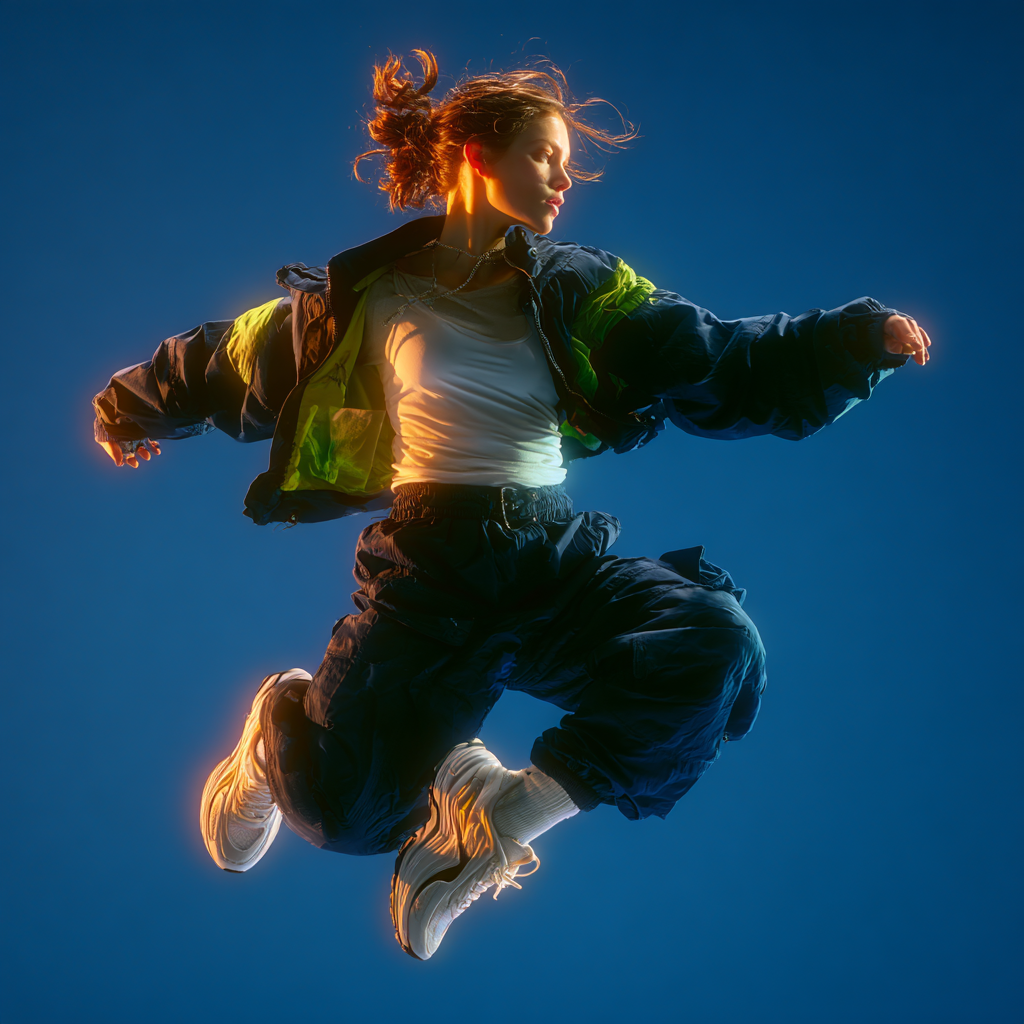
SDPose-OOD: De video a mapa de pose
Sube un video para extraer los puntos clave de la pose y generar un mapa de pose. El flujo de trabajo admite la detección de varias personas y usa un modelo SDPose mejorado para una extracción precisa de las características de todo el cuerpo.
Ejecutar en Comfy Cloud
Abrir en Comfy Cloud
Descargar flujo de trabajo
Descarga el JSON o busca “SDPose-OOD: Video to Pose Map” en la Biblioteca de plantillas
LoadVideo correspondiente:
man_in_the_rain.mp4
nodo
LoadVideo 679 · man_in_the_rain.mp42. Descargar modelos
Los checkpoints de los modelos SDPose y RT-DETRv4 están alojados en el repositorio de modelos Comfy-Org SDPose. checkpoints (modelo SDPose): diffusion_models (detector RT-DETRv4):- rt_detr_v4-x-hgnet_fp16.safetensors (recomendado)
- rt_detr_v4-x-hgnet_fp32.safetensors (precisión completa, más grande)
3. Usar los flujos de trabajo
Multipersona (imagen)
- Entrada: Carga una imagen mediante el nodo
Load Image. Usa una imagen con una o más personas (ejemplo:group_photo.png). - Detección: El subgrafo
Image to Pose Map (SDPose Multi-Person)procesa la imagen y produce:- IMAGE: visualización del esqueleto de la pose superpuesta a la imagen
- keypoints: datos de puntos clave del cuerpo completo sin procesar
- bboxes: coordenadas de la caja delimitadora
- Opciones de dibujo: Configura qué partes del cuerpo dibujar:
draw_body,draw_hands,draw_face,draw_feet: alternar visibilidadstick_width,face_point_size: ajustar el estilo visualscore_threshold: confianza mínima para mostrar los puntos clave
- Opciones de detección:
resize_type.longer_size: escalar la dimensión más larga antes de la detecciónmax_detections: número máximo de personas a detectardetect_threshold: umbral de confianza de deteccióndetect_class: clase de objeto a detectar (predeterminado: person)
Multipersona (video)
Igual que el flujo de trabajo de imagen, pero procesa los fotogramas de video de forma secuencial. UsaLoad Video para cargar un archivo de video y Save Video para exportar el resultado.
OOD de imagen a pose
Usa el modelo SDPose para generar un mapa de pose limpio a partir de una imagen, sin visualización de la caja delimitadora. Esto es útil para la transferencia de estilo, donde quieres extraer la pose del esqueleto de una imagen y aplicarla a otra.OOD de video a mapa de pose
Genera mapas de pose por fotograma a partir de un video. La salida es un archivo de video en el que cada fotograma contiene el esqueleto de la pose extraído, adecuado para animación o flujos de trabajo de ControlNet posteriores.Acerca de Subgraph
Estos flujos de trabajo usan nodos Subgraph para el procesamiento modular. Consulta la documentación de Subgraph para aprender a personalizar y ampliar los flujos de trabajo.
Notas adicionales
- Directorio de modelos: el checkpoint de SDPose va en
models/checkpoints/, y el detector RT-DETRv4 va enmodels/diffusion_models/ - Ejemplo de imagen de entrada: el archivo
group_photo.pngestá disponible en el directorioinput/de la plantilla del flujo de trabajo para hacer pruebas - Salida de keypoints: el tipo POSE_KEYPOINT se puede conectar a nodos posteriores que aceptan datos de pose para la generación condicional
- Actualización requerida: el soporte de SDPose + RT-DETRv4 está disponible en versiones recientes de ComfyUI. Asegúrate de que tu ComfyUI esté actualizado.