

LTX-Video es un modelo de video muy eficiente de Lightricks. Lo importante con este modelo es darle prompts largos y descriptivos.
Asegúrate de que tu ComfyUI esté actualizado.Los flujos de trabajo de esta guía se encuentran en las Plantillas de flujos de trabajo. Si no los encuentras en las plantillas, es posible que tu ComfyUI esté desactualizado.Si faltan nodos al cargar un flujo de trabajo, estas son las posibles razones:
  1. No estás usando la última versión de ComfyUI (versión nocturna)
  2. Algunos nodos fallaron al importarse durante el inicio

Control de múltiples fotogramas

Te permite controlar el video con una serie de imágenes. Puedes descargar las imágenes de entrada: fotograma inicial y fotograma final. Control de múltiples fotogramas de LTX-Video
Arrastra el video directamente a ComfyUI para ejecutar el flujo de trabajo.

Imagen a video

LTXV Image to Video

Genera videos a partir de imágenes fijas. Vista previa del flujo de trabajo LTXV Image to Video
Ejecutar en Comfy Cloud

Abrir en Comfy Cloud

Descargar flujo de trabajo

Descarga el JSON o busca “LTXV Image to Video” en la Biblioteca de plantillas
Materiales de entrada Sube este archivo al nodo LoadImage correspondiente:

ltxv_image_to_video_input_image.jpg

Nodo LoadImage 78 · ltxv_image_to_video_input_image.jpg
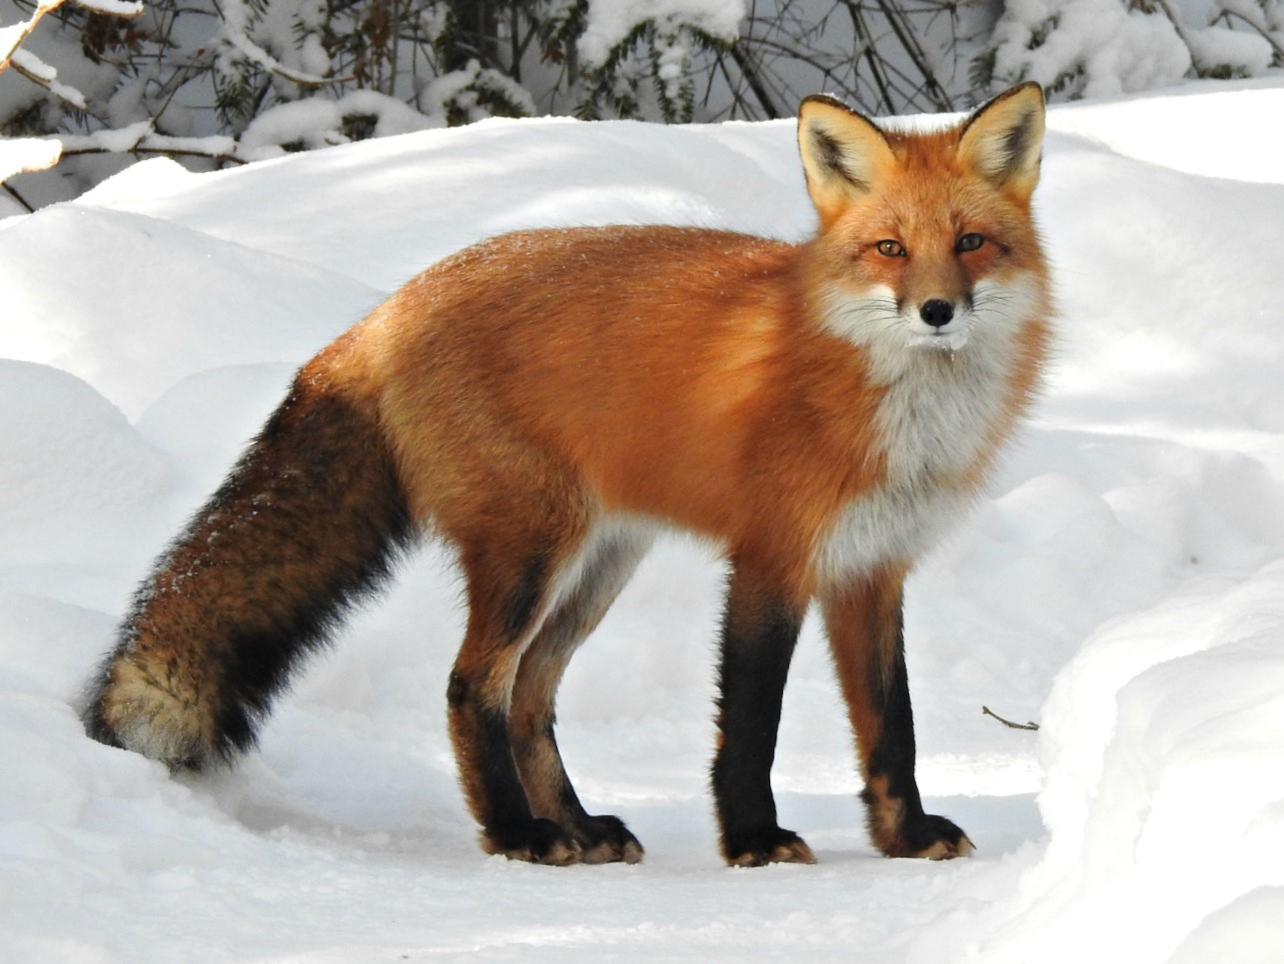
ltxv_image_to_video_input_image.jpg
Arrastra el video directamente a ComfyUI para ejecutar el flujo de trabajo.

Texto a video

LTXV Text to Video

Genera videos a partir de prompts de texto. Vista previa del flujo de trabajo LTXV Text to Video
Ejecutar en Comfy Cloud

Abrir en Comfy Cloud

Descargar flujo de trabajo

Descargar JSON o buscar “LTXV Text to Video” en la Biblioteca de plantillas
Arrastra el video directamente a ComfyUI para ejecutar el flujo de trabajo.

Requisitos

Descarga los siguientes modelos y colócalos en las ubicaciones que se indican a continuación:

ltx-video-2b-v0.9.5.safetensors

Descarga y guárdalo en ComfyUI/models/checkpoints/

t5xxl_fp16.safetensors

Descarga y guárdalo en ComfyUI/models/text_encoders/