

- 8 步,无 CFG:一条蒸馏采样计划和单个正向条件,不使用负面提示词
- 8 百万像素:支持方形、4:3、3:2、16:9 及其竖版,最高可达 3872 x 2176
- 内置提示词上采样器:你的一句话请求会被扩展为完整提示词,扩展后的提示词会显示在工作流中
- 借助参考图进行编辑:第一张图像是被编辑的对象,后续图像会在提示词中成为
<Picture 2>、<Picture 3>等 - 仅支持图像:P-H3-Image 不生成视频或音频
依赖项
- ComfyUI 0.44.0 或更高版本。两个模板都使用 0.44.0 中新增的 PH3ImageConditioning 节点
- 约 35 GB 的模型文件。该 diffusion 模型与 MiniMax H3 工作流所使用的是同一个,因此你可能已经拥有它
- 用于运行 int8 文件、显存约 21 GB 的 GPU
模型下载
扩散模型(INT8)
minimax_h3_fl2va_pruned_int8_convrot.safetensors → ComfyUI/models/diffusion_models/
文本编码器(INT8)
p-h3-image_text_encoder_int8_convrot.safetensors → ComfyUI/models/text_encoders/
提示词放大器(W4A8)
p-h3-image_prompt_upsampler_w4a8.safetensors → ComfyUI/models/text_encoders/
VAE(INT8)
p-h3-image_vae_int8_convrot.safetensors → ComfyUI/models/vae/
LoRA(BF16)
p-h3-image_lora_bf16.safetensors → ComfyUI/models/loras/
P-H3-Image 文生图工作流
用一句话的请求生成 8 百万像素的图像。该模板会先运行提示词上采样器,然后执行 8 步调度。
下载工作流
下载 JSON,或在模板库中搜索“P-H3-Image: Text to Image”
Request: 之后写下请求,并让 Aspect ratio: 行与分辨率选择器保持一致。选择器设为 8 百万像素、32 的倍数,由此得到以下画布:
- 采样:8 步是模型自身的调度。增加步数不会带来更多细节,也没有 CFG 或负面提示词需要调整
- 种子:设为
randomize可生成新图像,改回fixed可复现随附示例 - 上采样后的提示词:Preview Any 节点会显示重写后的提示词。在修改请求之前,值得先读一读
P-H3-Image 图像编辑工作流
用一句简短指令编辑照片,总共最多可使用九张图像。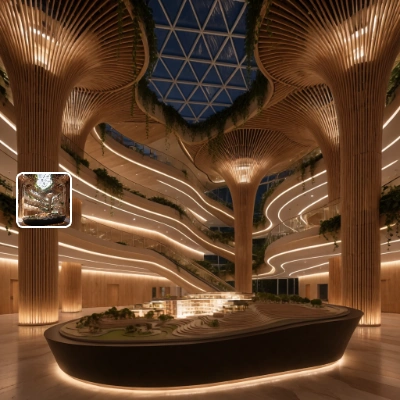
下载工作流
下载 JSON,或在模板库中搜索“P-H3-Image: Image Edit”
输入图像:image_p_h3_image_edit_atrium_day.png
工作流的来源图像,你也可以使用自己的照片。
Load Image 节点,并在 Request: 之后描述期望的结果。输出会遵循该图像的形状,因此条件节点上的宽度和高度输入保持为 0。
- 来源尺寸:编辑结果按第一张图像的尺寸渲染,并放大到至少 4 百万像素
- 更多参考:连接额外的图像,即可在提示词中加入
<Picture 2>、<Picture 3>以及更多参考 - 需要保留的内容:说明哪些部分不能改变。若不说明,模型往往会重绘整个场景
提示词技巧
- 说明图像是什么:用一句话点明真实物体,例如“由经验丰富的街头摄影师拍摄的照片”或“双色 Risograph 印刷品”。这比风格词更能可靠地确定外观
- 只描述一个场景:给出一个视角、一个被定格的瞬间中的主要主体、几个辅助元素,以及有来源和方向的光线
- 为每一段文字加上引号:没有写出确切词语的文字会变成伪文字。把每个字符串放进引号中,保持简短,说明它所在的位置,并以“no other text”结尾
- 去掉溢美之词:诸如 stunning、epic、cinematic 或 8k 之类的词会把模型推向光滑、过饱和的外观
限制
- 较低分辨率会出现更多瑕疵:在 2 百万和 4 百万像素下,面部、手部和小细节比在 8 百万像素下更容易崩坏
- 手部和背景人物可能会崩坏:背景中的小人可能会变形。以 8 百万像素渲染会有所改善
- 文字并非完全可靠:短的引号字符串渲染良好,但正文文案或长代码等密集文字会变成伪文本
- 对提示词敏感:过长的提示词会让图像变差,而过短的提示词在缺少 upsampler 时效果不佳