

Introducción a ComfyUI Depth Anything 3
Depth Anything 3 (DA3), de ByteDance Seed, es un vision transformer que recupera geometría espacialmente consistente a partir de entradas visuales arbitrarias, con o sin poses de cámara conocidas. Un único encoder DINO simple y una representación unificada de rayos de profundidad permiten que una sola familia de modelos cubra profundidad monocular, profundidad multivista, estimación de pose de cámara y reconstrucción 3D. Capacidades clave:- Profundidad monocular y multivista unificada: estima la profundidad a partir de una sola imagen o de varias vistas
- Estimación de pose de cámara: recupera las posiciones de cámara a partir de conjuntos de imágenes sin orden
- Reconstrucción 3D a partir de entradas multivista
- Estimación de profundidad en video: secuencias de profundidad por fotograma para entradas de video
- Múltiples variantes de modelo: Small, Base, Mono/Metric Large
Instalación del modelo
Descarga los checkpoints de Depth Anything 3 y guárdalos en la carpeta correspondiente de ComfyUI:- Small (depth_anything_3_small.safetensors): Ligero, inferencia rápida
- Base (depth_anything_3_base.safetensors): Rendimiento equilibrado
- Mono-Large (depth_anything_3_mono_large.safetensors): La mejor opción para profundidad monocular, incluye detección de cielo
- Metric-Large (depth_anything_3_metric_large.safetensors): Profundidad a escala métrica en metros, incluye detección de cielo
Flujos de trabajo de ejemplo
Depth Anything 3: estimación de profundidad de imagen
Sube una imagen y genera un mapa de profundidad con Depth Anything 3. Consulta una comparación lado a lado de la imagen original y la salida de profundidad.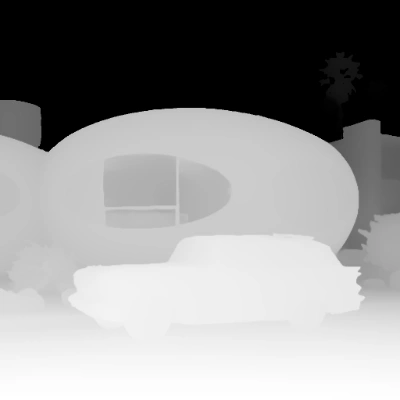
Ejecutar en Comfy Cloud
Abrir en Comfy Cloud
Descargar flujo de trabajo
Descargar JSON o buscar “Depth Anything 3: Image Depth Estimation” en la Biblioteca de plantillas
LoadImage correspondiente:
retro_futuristic_home.png
nodo
LoadImage 85 · retro_futuristic_home.png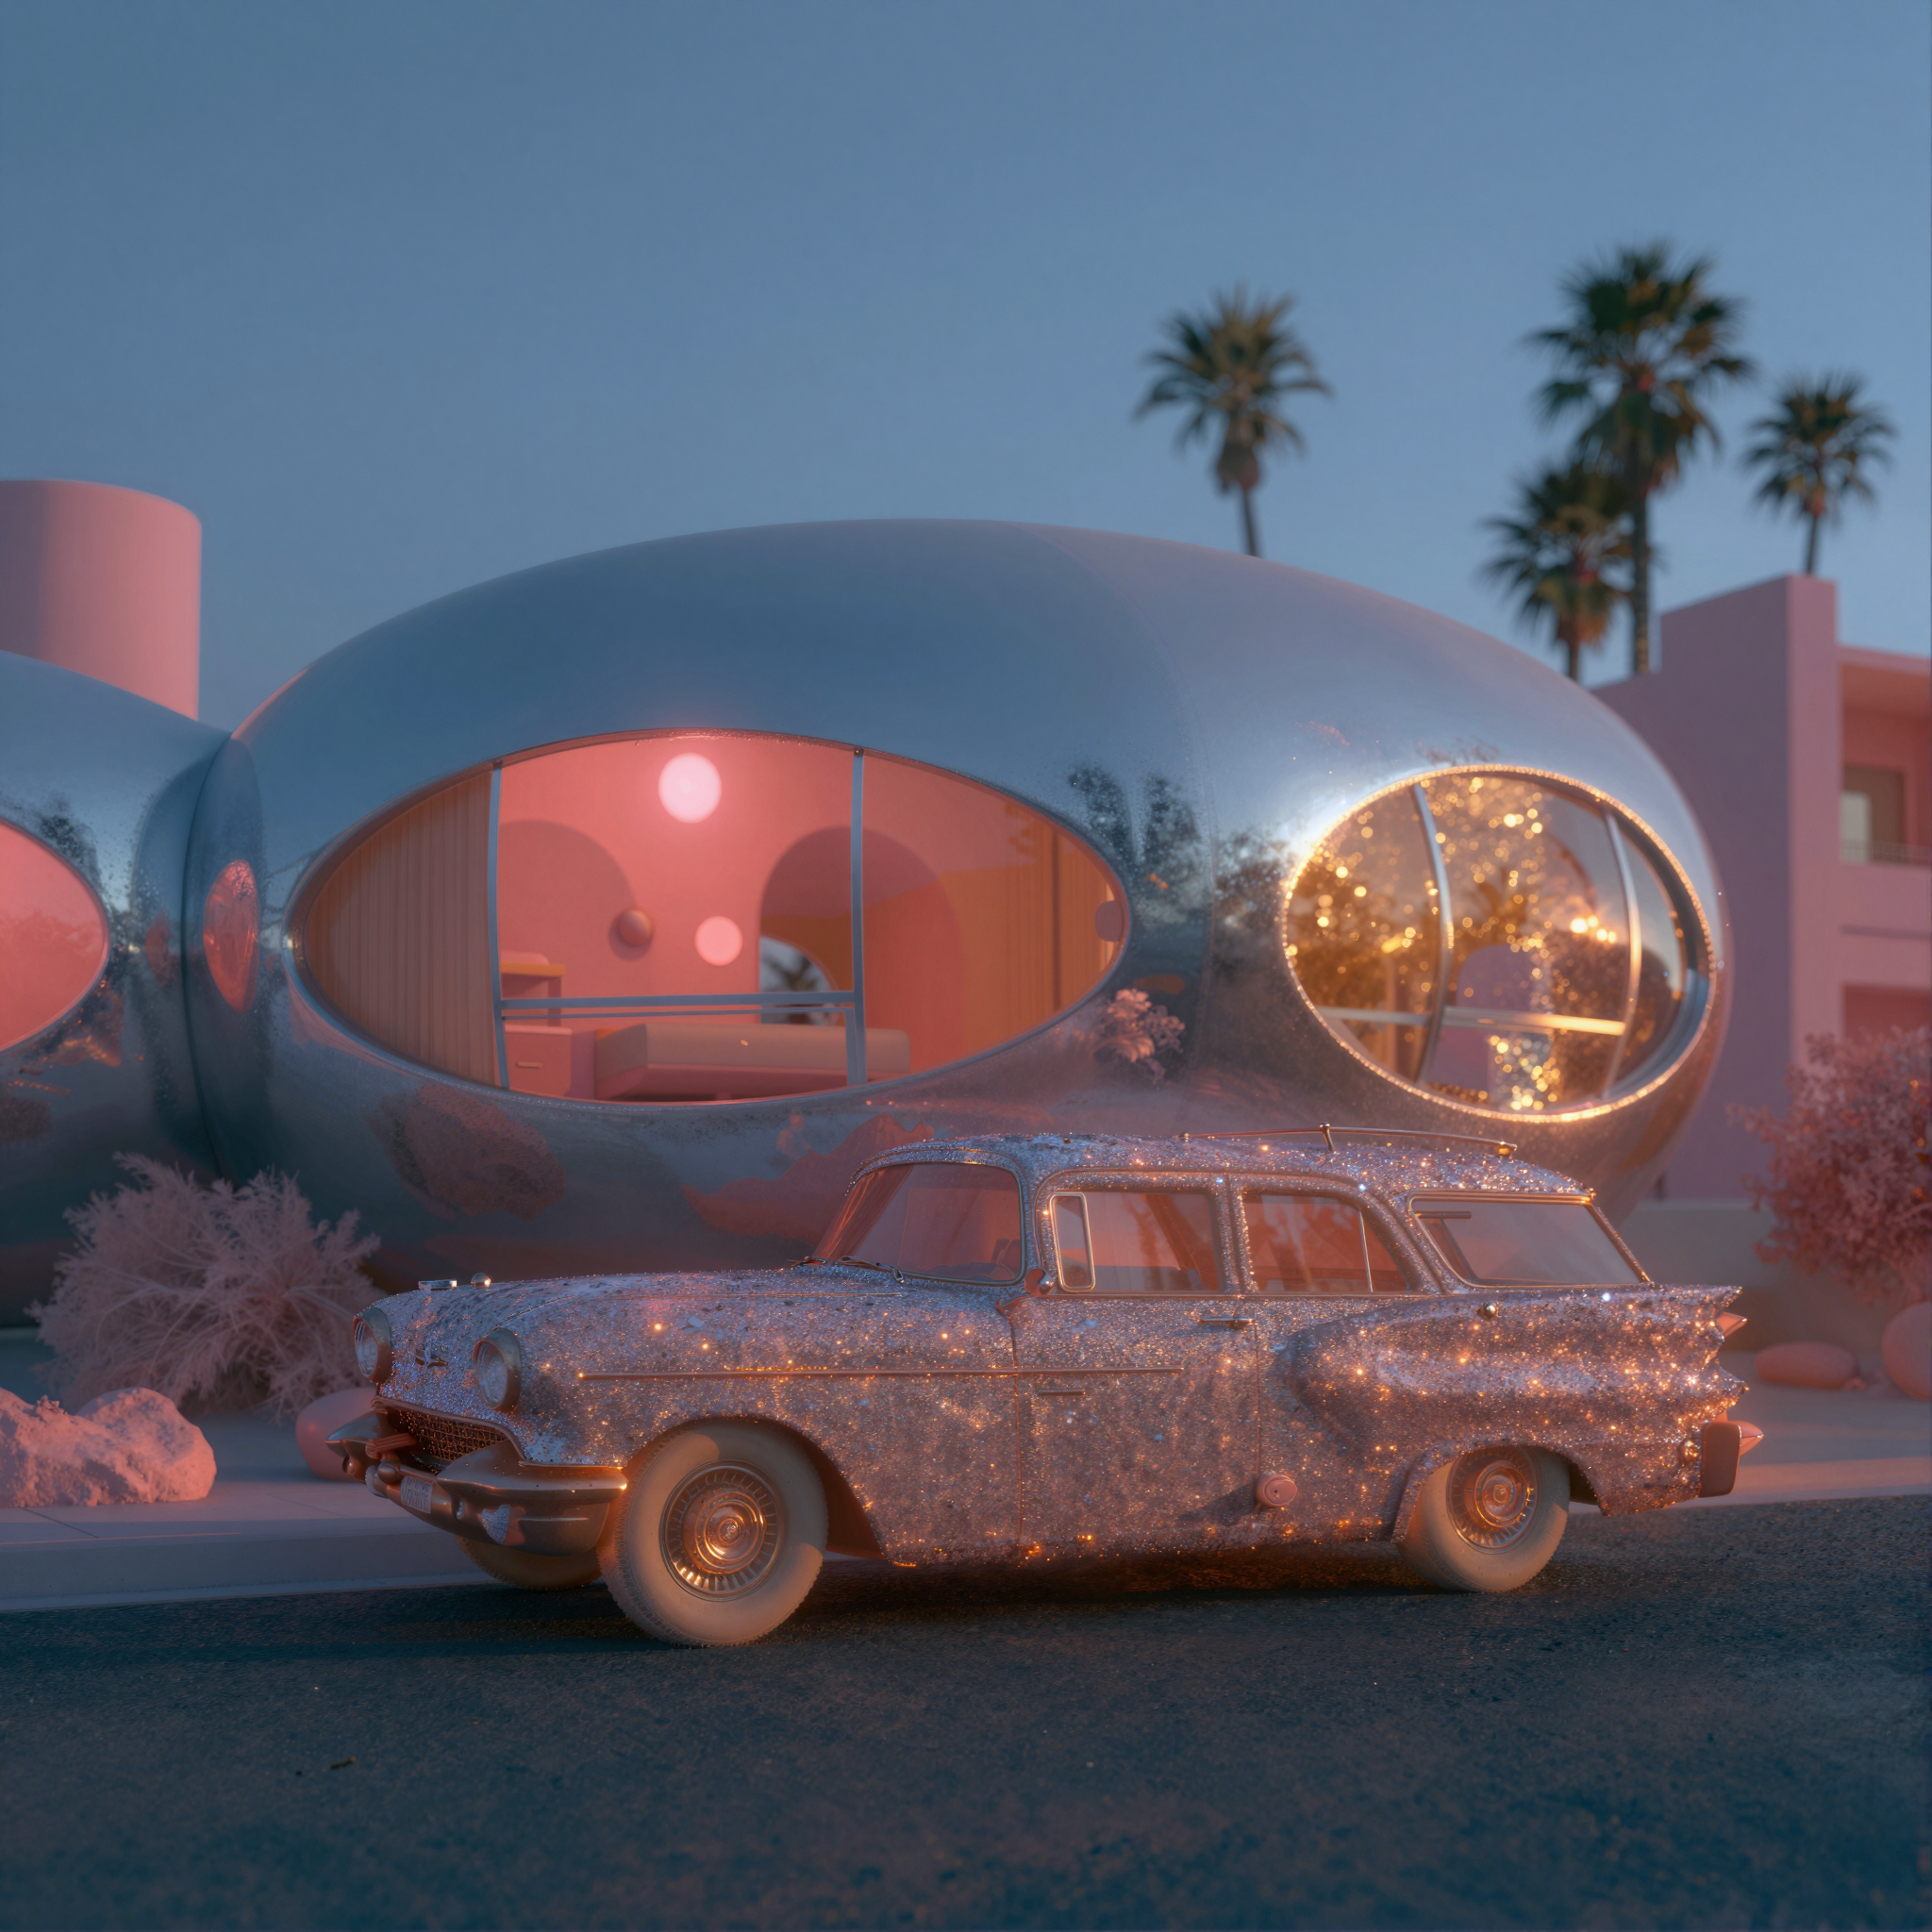
Pasos para ejecutar
- LoadImage: carga tu imagen de entrada
- LoadDA3Model: selecciona una variante de Depth Anything 3
- Run: haz clic en Queue o usa
Cmd+Enter - El flujo de trabajo genera un mapa de profundidad y una comparación lado a lado
Acerca de Subgraph
Este flujo de trabajo usa nodos Subgraph para el procesamiento modular. Consulta la documentación de Subgraph para aprender a personalizar y extender el flujo de trabajo.
Depth Anything 3: estimación de profundidad de video
Sube un video para generar una secuencia de profundidad por fotograma. Dentro del subgrafo, GetVideoComponents divide el video de entrada en fotogramas, LoadDA3Model carga el modelo y SetVideoComponents vuelve a ensamblar los fotogramas de profundidad en un video de salida.
Ejecutar en Comfy Cloud
Abrir en Comfy Cloud
Descargar flujo de trabajo
Descargar JSON o buscar “Depth Anything 3: Video Depth Estimation” en la Biblioteca de plantillas
LoadVideo correspondiente:
empty_room_assembly.mp4
nodo
LoadVideo 87 · empty_room_assembly.mp4Pasos para ejecutar
- LoadVideo: carga tu video de entrada
- Seleccionar modelo: elige entre Small, Base, Mono-Large o Metric-Large
- Run: haz clic en Queue o usa
Cmd+Enter - El flujo de trabajo genera un video con mapas de profundidad por fotograma
Acerca de Subgraph
Este flujo de trabajo usa nodos Subgraph para el procesamiento modular. Consulta la documentación de Subgraph para aprender a personalizar y extender el flujo de trabajo.
Variantes del modelo
- Small y Base usan el tipo de head
dualdptcon estimación de confianza y soporte del decodificador de cámara para aplicaciones multivista. - Mono-Large y Metric-Large usan el tipo de head
dptcon detección de cielo. Metric-Large genera profundidad sin procesar en metros.
Recursos de la comunidad
- Depth Anything 3 GitHub (ByteDance-Seed): artículo de investigación y código
- Comfy-Org/Depth-Anything-3: pesos oficiales del modelo para ComfyUI