

Descripción general
Kandinsky 5.0 usa un pipeline de difusión latent con Flow Matching e incluye:- Diffusion Transformer (DiT): Arquitectura generativa principal con atención cruzada a los embeddings de texto
- Qwen2.5-VL y CLIP: Proporciona embeddings de texto de alta calidad
- HunyuanVideo 3D VAE: Codifica y decodifica el video en un espacio latent
- Modelo SFT: Máxima calidad de generación
- CFG-distilled: Inferencia 2× más rápida
- Diffusion-distilled: 6× más rápida con una pérdida mínima de calidad (16 pasos)
- Modelo preentrenado: Diseñado para fine-tuning
Variantes del modelo
Flujo de trabajo de texto a video
Kandinsky 5.0 Video Lite Text to Video
Un modelo ligero de 2B que genera videos a partir de prompts en inglés y ruso con alta calidad visual.
Ejecutar en Comfy Cloud
Abrir en Comfy Cloud
Descargar flujo de trabajo
Descarga el JSON o busca “Kandinsky 5.0 Video Lite Text to Video” en la Biblioteca de plantillas
2. Descargar los modelos manualmente
Codificadores de textoText Encoder: qwen_2.5_vl_7b_fp8_scaled.safetensors
Codificador de texto Qwen2.5-VL 7B (FP8). Colócalo en
ComfyUI/models/text_encoders/Text Encoder: clip_l.safetensors
Codificador de texto CLIP-L. Colócalo en
ComfyUI/models/text_encoders/Diffusion Model: kandinsky5lite_t2v_sft_5s.safetensors
Modelo de difusión Kandinsky 5.0 T2V Lite SFT (5 s). Colócalo en
ComfyUI/models/diffusion_models/VAE: hunyuan_video_vae_bf16.safetensors
VAE 3D de HunyuanVideo. Colócalo en
ComfyUI/models/vae/Flujo de trabajo de imagen a video
Kandinsky 5.0 Video Lite Image to Video
Un modelo ligero de 2B que genera videos a partir de prompts en inglés y ruso con alta calidad visual.
Ejecutar en Comfy Cloud
Abrir en Comfy Cloud
Descargar flujo de trabajo
Descarga el JSON o busca “Kandinsky 5.0 Video Lite Image to Video” en la Biblioteca de plantillas
LoadImage correspondiente:
crystal_flower.png
Nodo
LoadImage 11 · crystal_flower.png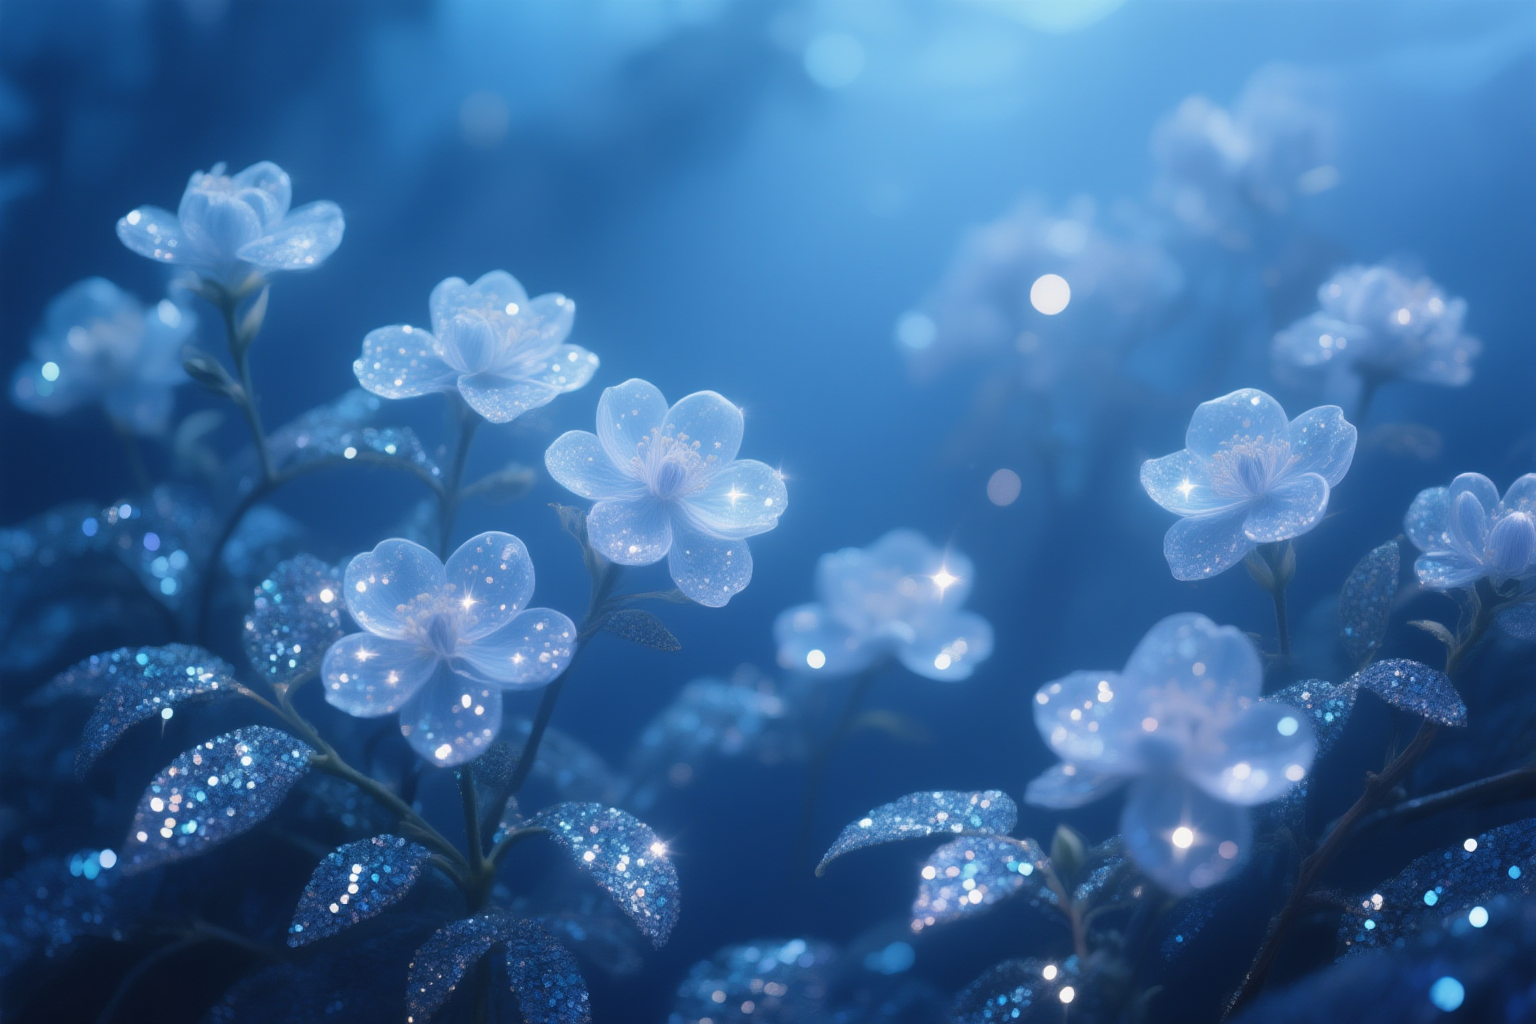
2. Descargar los modelos manualmente
Codificadores de textoText Encoder: qwen_2.5_vl_7b_fp8_scaled.safetensors
Codificador de texto Qwen2.5-VL 7B (FP8). Colócalo en
ComfyUI/models/text_encoders/Text Encoder: clip_l.safetensors
Codificador de texto CLIP-L. Colócalo en
ComfyUI/models/text_encoders/Diffusion Model: kandinsky5lite_i2v_5s.safetensors
Modelo de difusión Kandinsky 5.0 I2V Lite (5 s). Colócalo en
ComfyUI/models/diffusion_models/VAE: hunyuan_video_vae_bf16.safetensors
VAE 3D de HunyuanVideo. Colócalo en
ComfyUI/models/vae/