

- 生成与编辑合一:同一套权重既可用于文生图提示词,也可用于编辑指令,因此工作流无需切换模型
- 原生 2K 输出:直接生成最高 2048x2048 的图像,而无需对较小结果进行图像放大
- 专业排版:密集的小号文字和复杂版式依然清晰,适用于信息图、幻灯片、UI 原型图、海报和包装设计
- Alpha 通道支持:VAE 携带四个通道,因此可以直接生成和编辑透明背景图像,而无需事后再进行抠图
- 多图像编辑:参考图像按槽位顺序拼接到文本编码器中。Text Encode Qwen Image 2.1 节点最多接受 16 个槽位(
image_1到image_16);本页两个编辑模板接入了前 10 个(image_1到image_10)。image_1是被编辑的图像,其余提供内容,因此提示词通过索引引用它们,例如image_1写作<image1> - 局部编辑:描述要更改的对象或区域,图像的其余部分保持不变
Qwen-Image-2.1 工作流
Qwen Image 2.1 文本到图像
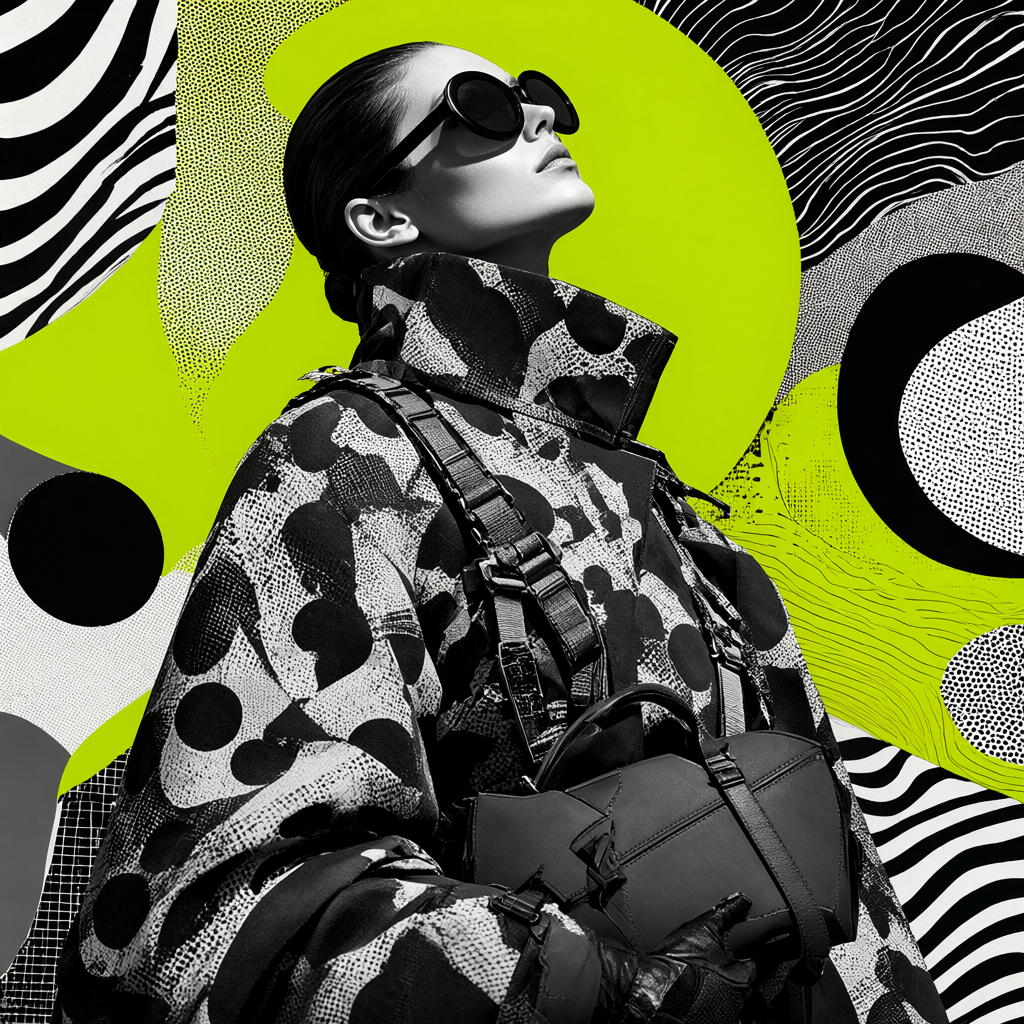
根据您选择的宽高比和百万像素目标,从文本提示生成图像。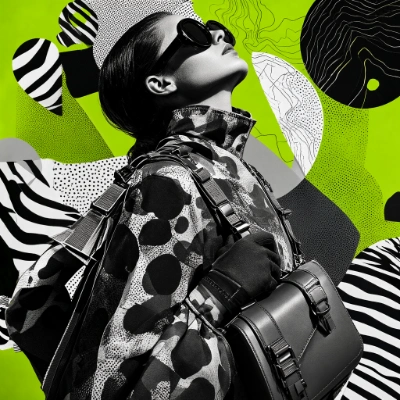
下载工作流
下载 JSON 或在模板库中搜索 “Qwen-Image-2.1”
在 Comfy Cloud 上运行
零设置在线运行 ComfyUI
Qwen Image 2.1 图像编辑
使用指令编辑图像。当编辑需要源图像中不存在的内容时,添加参考图像,例如将第二张照片中的服装穿到第一张照片中的人物身上。
下载工作流
下载 JSON 或在模板库中搜索 “Qwen-Image-2.1”
在 Comfy Cloud 上运行
零设置在线运行 ComfyUI
LoadImage 节点:
portrait_model_denim.png
LoadImage 节点 470 · portrait_model_denim.pngclothing_light_blue_denim_shirt.png
LoadImage 节点 475 · clothing_light_blue_denim_shirt.png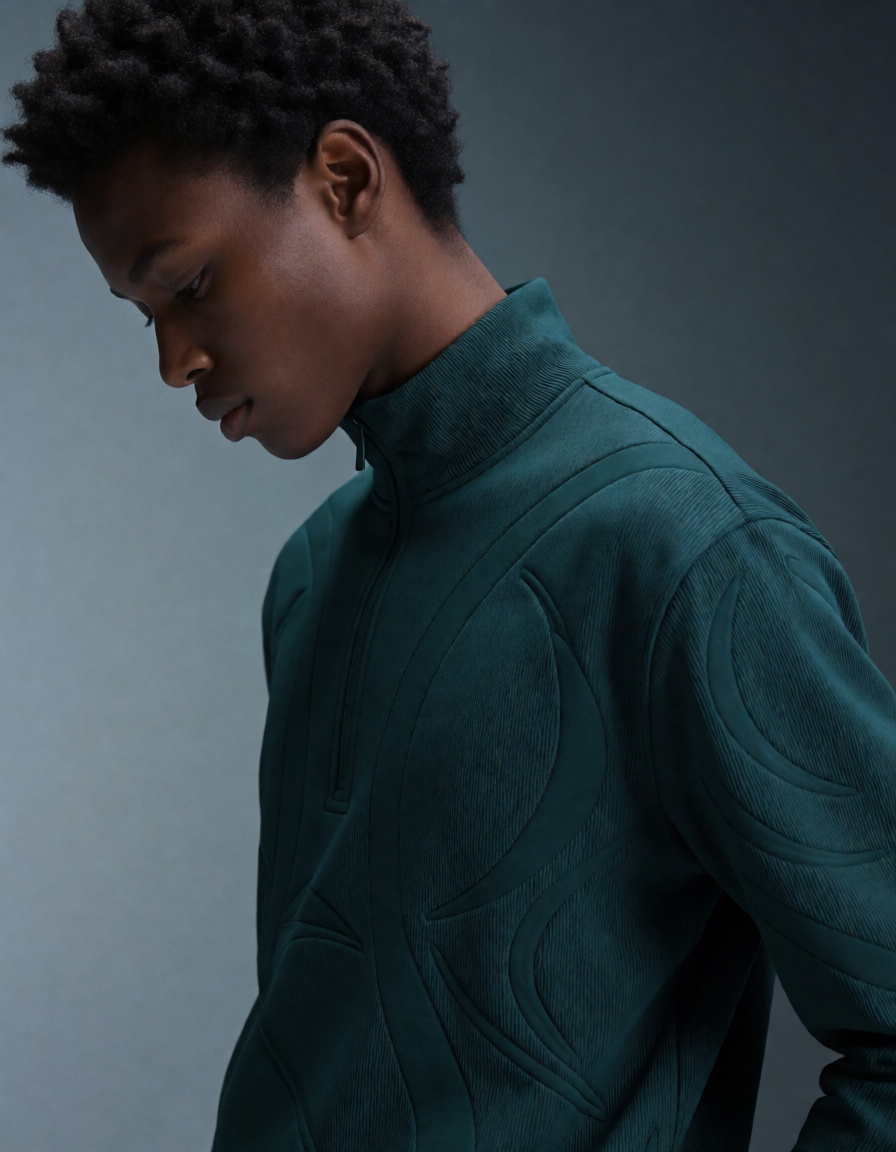
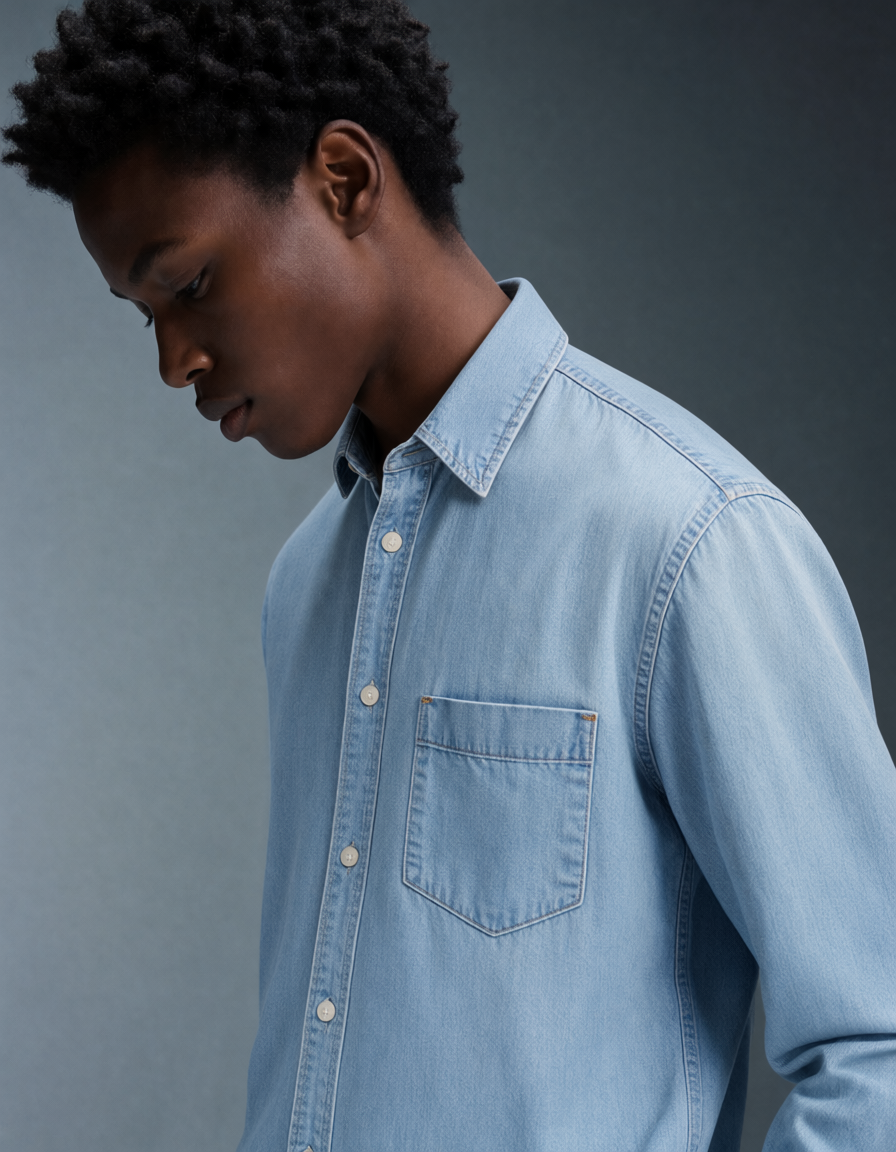
移除背景:Qwen Image 2.1
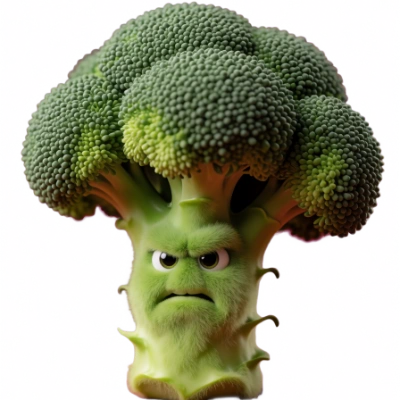
使用编辑指令移除照片的背景。该工作流复用图像编辑子图,提示词为Remove the background, and output a PNG image,并将结果与原始图像进行对比。
下载工作流
下载 JSON 或在模板库中搜索 “Qwen-Image-2.1”
在 Comfy Cloud 上运行
零设置在线运行 ComfyUI
LoadImage 节点:
angry_broccoli.png
LoadImage 节点 470 · angry_broccoli.pngQwen Image 2.1 Turbo:文本到图像
使用 Qwen Image 2.1 Turbo 从文本提示词生成图像。它是同一模型的蒸馏 checkpoint,只需 8 步采样,而不是基础模型的 25 步。输出尺寸同样由分辨率选择器节点决定,可选的提示词增强行为与基础工作流一致。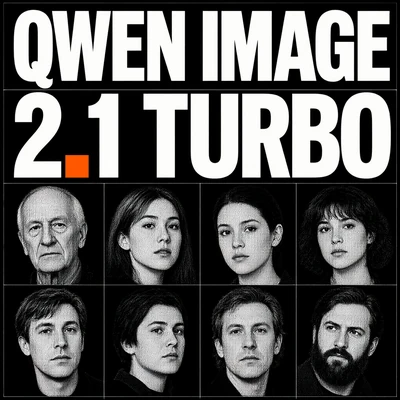
下载工作流
下载 JSON 或在模板库中搜索 “Qwen Image 2.1 Turbo”
在 Comfy Cloud 上运行
零设置在线运行 ComfyUI
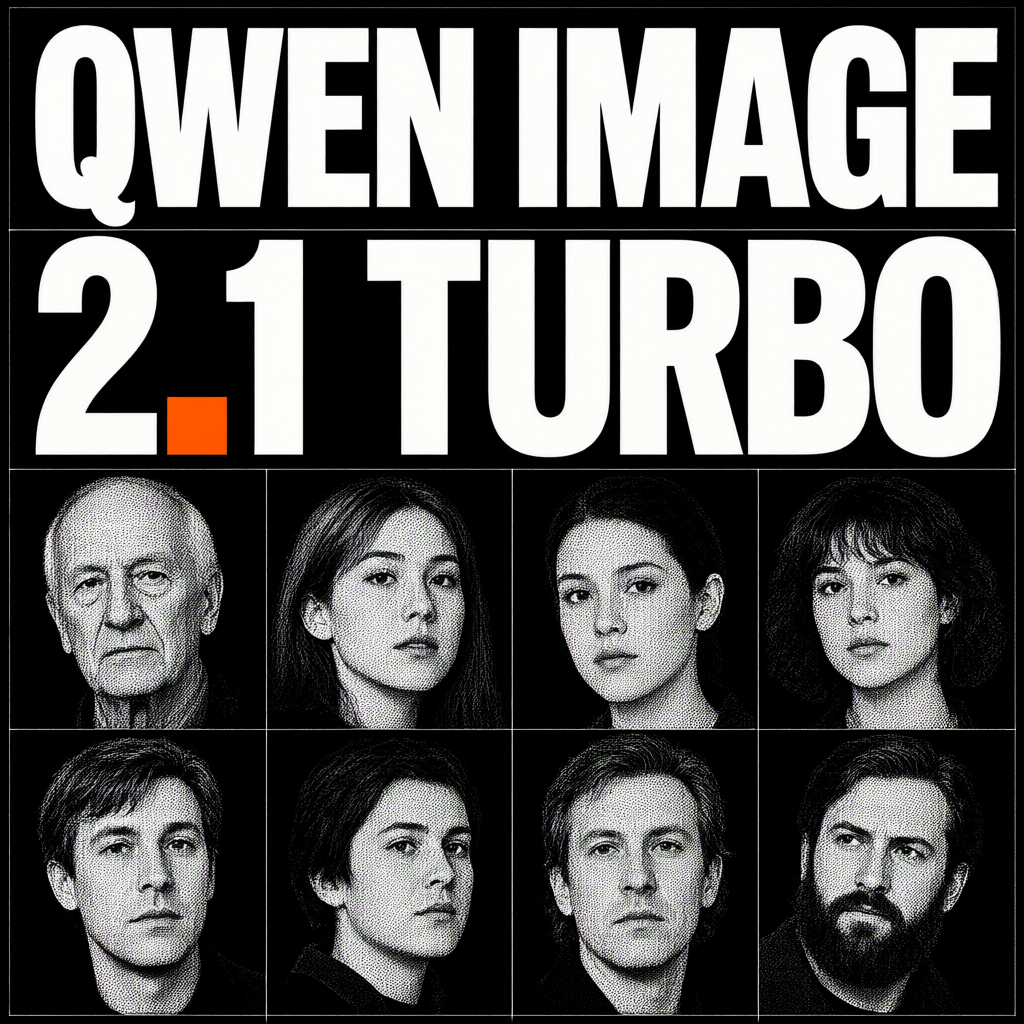
Qwen Image 2.1 Turbo:图像编辑
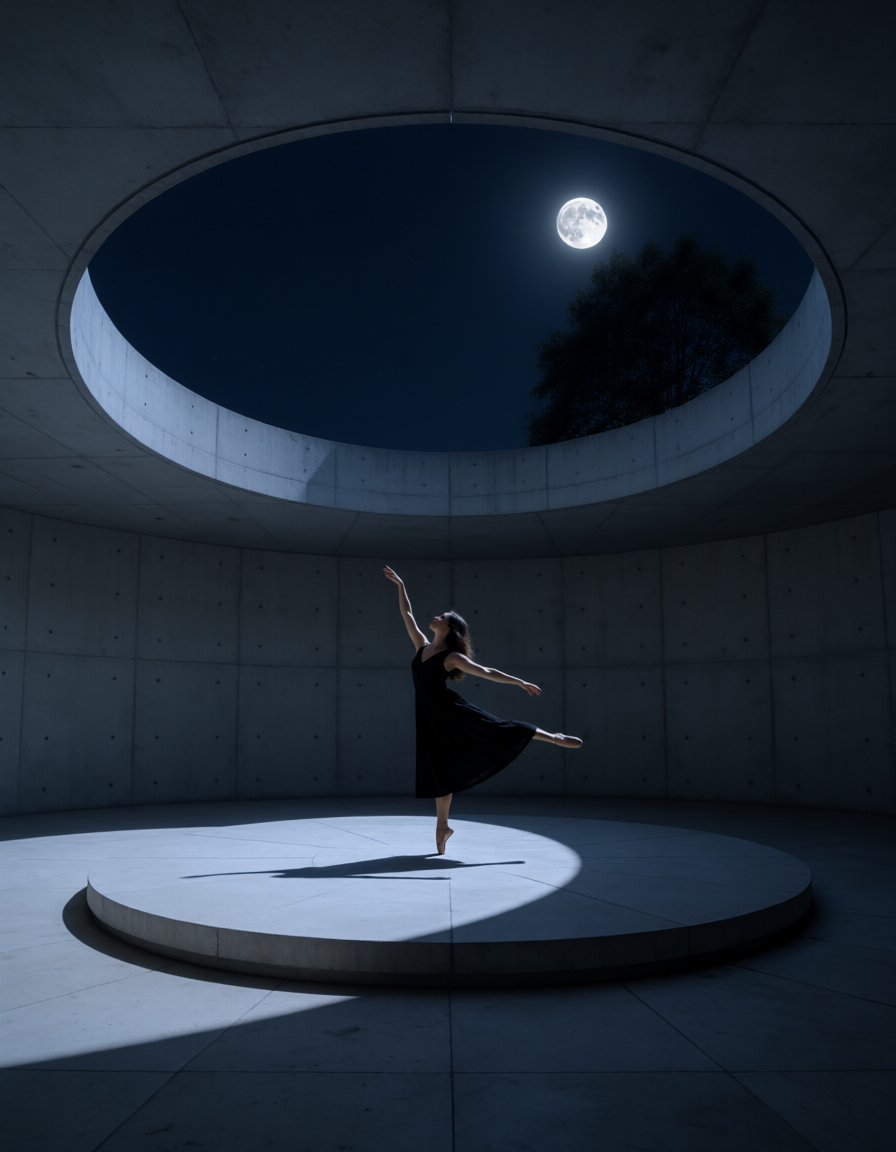
使用同一个 8 步 Turbo checkpoint 按指令编辑图像。参考图插槽的行为与基础图像编辑工作流相同:image_1 是被编辑的图像,其余插槽提供内容,提示词按索引以 <image1>、<image2> 的方式指向它们。
下载工作流
下载 JSON 或在模板库中搜索 “Qwen Image 2.1 Turbo”
在 Comfy Cloud 上运行
零设置在线运行 ComfyUI
LoadImage 节点:
ballet_dancer_photography_minimalist_architecture.png
LoadImage 节点 470 · ballet_dancer_photography_minimalist_architecture.png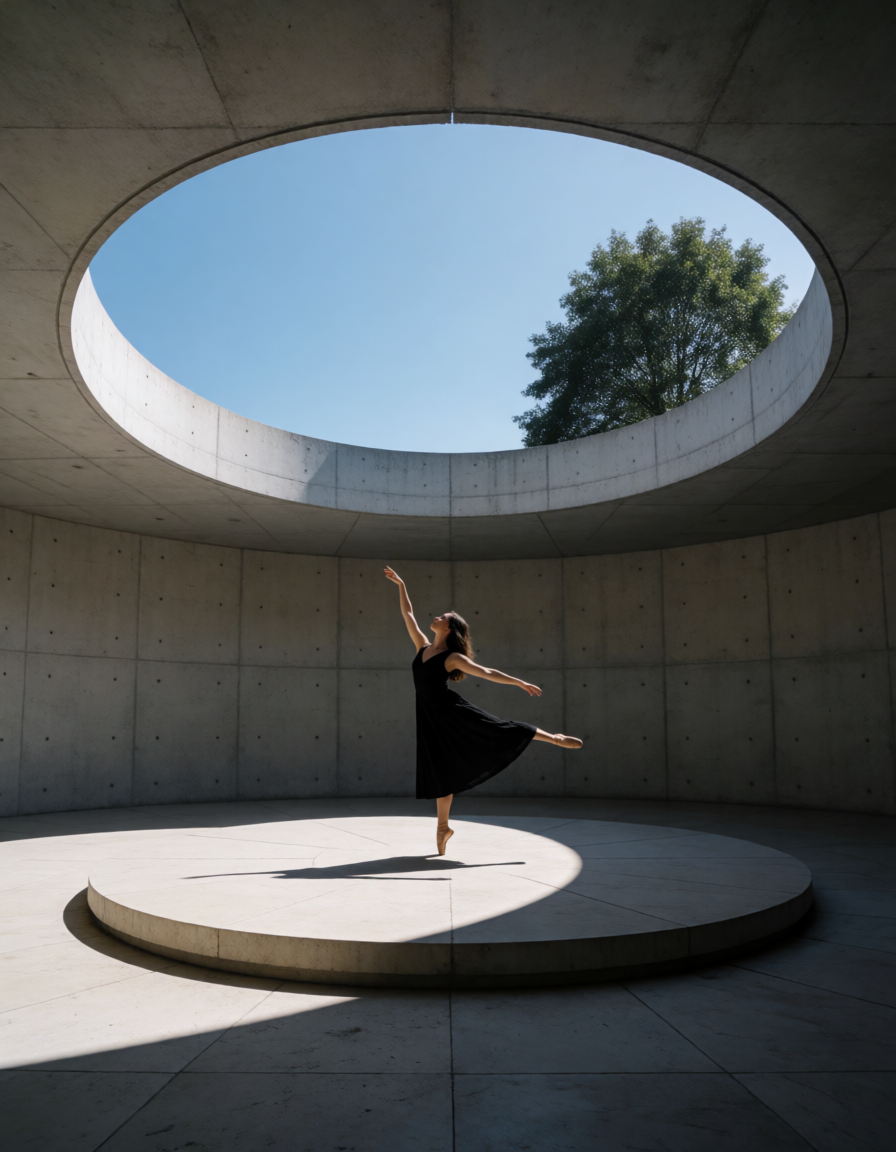
模型下载
本页所有工作流共用相同的 VAE 和基础文本编码器,文生图和图像编辑模板各自额外加载一个提示词增强文本编码器:文生图为qwen3.5_9b_qwen_image_2.1_pe_t2i,图像编辑为 qwen3.5_9b_qwen_image_2.1_pe_i2i。两个 Turbo 模板则改用 Turbo 扩散模型,替代基础模型。
text_encoders
- qwen3vl_8b_int8_convrot.safetensors(模板默认加载,内存占用更低)
- qwen3vl_8b_bf16.safetensors(完整精度,需要更多内存)
- qwen3.5_9b_qwen_image_2.1_pe_t2i.int8_convrot.safetensors(文生图模板的提示词增强)
- qwen3.5_9b_qwen_image_2.1_pe_i2i.int8_convrot.safetensors(图像编辑模板的提示词增强)
- qwen_image_2.1_int8_convrot.safetensors(基础模板默认加载,内存占用更低)
- qwen_image_2.1_bf16.safetensors(完整精度,需要更多内存)
- qwen_image_2.1_turbo_int8_convrot.safetensors(Turbo 模板默认加载,内存占用更低)
- qwen_image_2.1_turbo_bf16.safetensors(Turbo 完整精度,需要更多内存)
工作流设置
Sampler 设置
基础工作流使用steps 25、cfg 1、euler sampler 和 simple scheduler 进行采样。两个 Turbo 模板改为 8 步采样,使用 cfg 1、euler sampler 以及随蒸馏 checkpoint 一同提供的固定 ManualSigmas 调度,因此只有在更换调度时才应提高步数。
当 cfg 为 1 时,ComfyUI 会跳过负向条件的计算,因此在这些工作流中负向提示词不起作用。模板保持 cfg 1,这是 Qwen-Image-2.1 发布时所对应的路径;只有当你希望负向提示词生效时才调高它。cfg 2 能更紧密地遵循复杂提示词(包括小字号文本和数字),代价是边缘过度锐化。再往上调会让画面偏亮或偏暗,cfg 5 会严重降低质量,cfg 0.5 会破坏图像。请一次只改一个取值,并在固定种子下进行比较。
steps 是基础工作流的第二个可调项:两个 Turbo 模板使用固定的 8 步 ManualSigmas 调度,因此下面的步数范围针对基础模型。Qwen-Image-2.1 发布的推理流程使用 euler sampler 和约 40 到 50 步,而基础模板从更低的 25 开始。简单的局部编辑在 4 到 8 步就能成立,因此像把某件衣服换成另一种颜色这类请求比默认设置快好几倍;而重写整幅画面的编辑会失去一致性,需要完整的 25 步。手部、手指这类难处理的细节大约在 30 步时收敛,而从 25 步提到 40 步可以减少细节区域的杂乱噪点。只有在某个具体细节始终无法收敛时才调整 steps。
分辨率
文本到图像:分辨率选择器节点设置宽高比和百万像素目标,其中 1.0 MP 约为 1024x1024。Qwen-Image-2.1 原生生成 2K 图像,因此对于 2048x2048 的方形输出,将目标设置为约 4.0 MP。 图像编辑:画布由 Image Edit 子图节点上的resolution 控件决定(范围 0 到 4096,步长 32)。节点自身默认为 1024,模板给的是 0。当 custom_size 关闭时(模板默认设置),编辑在首张参考图 image_1 的尺寸下生成:
resolution为0时每张参考图保持自身像素尺寸,并四舍五入到 32 的倍数,因此 3000x4000 的照片会得到 3008x4000 的画布resolution大于0时,将image_1的宽高比缩放至resolutionxresolution的像素预算,这是总像素数而非宽或高,并四舍五入到 32 的倍数,因此同一张照片在resolution为1024时约为 896x1184
custom_size 则改用分辨率选择器提供的画布,并尽量接近调整后的 image_1 尺寸,否则编辑可能偏移。
决定开销的是画布尺寸:3000x4000 的参考图在 resolution 为 0 时按 3008x4000(约 12 MP)采样,同一次编辑在 resolution 1024 时按约 896x1184(约 1 MP)采样。在 RTX 5090 上分别是约 6 s/it 和约 0.3 s/it。降低 resolution 是通过生成更小的结果提速,并不会增加细节。如果编辑感觉很慢,先检查 resolution 和参考图像的像素尺寸,再考虑改动其它参数。多张较大的参考图像会进一步拖慢编辑,下方的 KV 缓存设置会影响这部分开销。另外,远超模型 2K 训练尺寸的目标(例如 4K)会降低提示词遵循度。
图像编辑提示
参考图像按插槽顺序拼接到文本编码器中,提示词通过索引指向每张图像:image_1 的 LoadImage 节点(节点 470:右键点击节点,选择用遮罩编辑器打开)上用 Paint Pen 涂抹该区域后保存。Paint Pen 画在图像的 RGB 图层上,不会写入遮罩,因此保存会把带标记的图像写回节点,标记也成为这次编辑读取的参考图的一部分。在提示词中指名标记的颜色,就能把指令指向该区域,例如“把红色区域里的夹克换掉”。标记要限制在需要修改的区域内;如果标记的颜色出现在结果里,就在提示词中一并写明你想要的颜色。
KV 缓存
编辑工作流包含 Qwen Image 2.1 Cache 节点,用于在采样步骤之间保留缓存的文本与参考前缀。模板默认设置适用于大多数情况。 该节点为实验性功能,提供两个控件:提示词增强
文生图和图像编辑模板包含一个可选的提示词增强步骤。它使用独立的文本编码器在采样前改写提示词,把简短的请求扩展为更详细的描述。 四个模板都在 Qwen Image 2.1 子图节点上提供以下控件:refine_prompt:四个模板默认都关闭。开启后图像模型使用改写后的提示词采样,而不是你输入的原始提示词PE_model:执行改写的文本编码器,文生图为qwen3.5_9b_qwen_image_2.1_pe_t2i.int8_convrot.safetensors,图像编辑为qwen3.5_9b_qwen_image_2.1_pe_i2i.int8_convrot.safetensorsthinking_mode(图像编辑模板中显示为thinking):四个模板默认都关闭。该 checkpoint 用推理块训练,关闭时会损失质量,因此请先提高max_length(见下文),再与refine_prompt一起开启max_length:推理过程和改写后提示词共享的 Token 预算。所有模板均为 4096,节点可设置到 32768
refine_prompt 时才会执行增强分支,四个模板中的增强文本编码器都是可选的;需要时开启 refine_prompt 即可。背景移除模板不包含此步骤。
所有模板都把 max_length 设为 4096,以免单次改写耗时数分钟。提示词增强模型卡(T2I、I2I)使用 max_new_tokens 16256(文生图)和 24000(图像编辑)采样,两者都开启 thinking。推理过程一旦耗尽 4096 预算就会无法结束,增强器随即返回空字符串。此时 Preview Any 显示为空,图像模型采样的就是这个空提示词:图像编辑返回接近原图的结果,文生图则完全丢失请求内容。开启 thinking 前把 max_length 提高到模型卡中的取值,改写的等待时间也会随之变长。
VAE 解码伪影
Qwen-Image-2.1 自带的 VAE 会在细节丰富的写实类输出上留下细密的棋盘状纹理。这类伪影来自解码器而不是采样过程,所以提高步数并不能消除它。 texture_fix_vae_for_qwen_image_2.1_bf16.safetensors 是同一个解码器的非官方微调版本,解码同一份 latent 时纹理更干净。把它放进ComfyUI/models/vae/,在 Load VAE 节点上选择它来替换 qwen_image_2.1_vae_bf16.safetensors。它以略低的还原精度换取更干净的纹理。
用 Turbo LoRA 加速采样
基础检查点的 Turbo LoRA 用 8 步、cfg 1 采样。官方文件位于 Comfy-Org/Qwen-Image-2.1 仓库:qwen_image_2.1_turbo_lora_avg_rank_178_bf16.safetensors。把它下载到 ComfyUI/models/loras/,用 LoraLoaderModelOnly 节点加载到送入采样器的模型线上。
Turbo 工作流 走的是另一条路:单独的 Turbo 扩散模型,配一套固定的 8 步 ManualSigmas 调度。LoRA 复用基础检查点,因此不需要再下载那个模型。基础模板本来就是 cfg 1 配 euler 和 simple,所以在 Qwen Image 2.1 子图节点上把 steps 设为 8,采样器和调度器保持模板原样即可。
用 Lightning LoRA 加速采样
基础工作流采样 25 步。Qwen-Image-2.1-Lightning 是面向同一基础检查点的非官方 4 步蒸馏 LoRA。把 pytorch_lora_weights.safetensors 下载到ComfyUI/models/loras/,用 LoraLoaderModelOnly 节点加载到送入采样器的模型线上。
该 LoRA 在 cfg 1 下按四步调度运行。它的模型卡给出的是 1.0, 0.75, 0.5, 0.25 这组网格,而这是采样调度做指数平移(exponential shift)之前的取值,不是采样器实际使用的数值。ComfyUI 的 Qwen-Image-2.1 采样设置自带同一个平移,按 1024x1024 拟合,所以在该分辨率下把 steps 设为 4、保留模板的 euler 与 simple,就能复现蒸馏时的调度:约 1.0, 0.857, 0.667, 0.4。在 Qwen Image 2.1 子图节点上把 steps 设为 4,调度器保持模板原样即可。
ManualSigmas 节点标记为实验性,会把填入的数值原样传递,所以手写调度必须直接填平移之后的数值。ComfyUI 的平移按 1024x1024 拟合,输出尺寸偏离该分辨率后两者的贴合度会下降。
Alpha 通道输出
Qwen-Image-2.1 的 VAE 解码出四个通道,所以解码后的图像除 RGB 之外还带 alpha。背景移除工作流就依赖这一点:透明背景是生成进 alpha 通道的,而不是事后抠出来的。 为三通道图像编写的节点和自定义节点在这类输出上可能报错,报错出现在接收图像的那个节点上,而不是 Qwen-Image-2.1 的节点上。在解码之后接一个SplitImageWithAlpha 节点,让这些节点使用它的 RGB 输出。这两个节点都遵循 1 表示透明像素的遮罩约定,所以前者的遮罩输出可以直接接到 JoinImageWithAlpha 的 alpha 输入。