

- MiniMaxAI/MiniMax-H3-Image (Hugging Face): 공식 모델 카드와 가중치
- MiniMax-H3-Image (ModelScope): 중국 본토용 공식 미러
- MiniMax-AI/MiniMax-H3-Image (GitHub): 공식 예제와 skill
- Comfy-Org/MiniMax-H3-Image (Hugging Face): diffusion 모델 및 이미지 VAE
- Comfy-Org/MiniMax-H3 (Hugging Face): 이 모델에서 사용하는 Qwen3-VL-32B 텍스트 인코더
- MiniMaxAI/MiniMax-H3-Image-PE (Hugging Face): 공식 프롬프트 확장기
주요 기능
- 하나의 checkpoint로 텍스트 기반 이미지 생성과 편집: 별도의 편집 모델이나 어댑터를 로드할 필요가 없습니다
- 6단계 샘플링: 가이드가 1로 고정되어 CFG 패스와 네거티브 프롬프트가 없습니다
- 기본 약 16 MP: 업스케일 패스 없이 4096 x 4096에서 최대 6272 x 2688
- 다중 레퍼런스: 최대 16개의 입력 이미지를 사용하며, 프롬프트에서
<Picture 1>부터 지정합니다 - 선택적 프롬프트 확장기: 짧은 요청을 모델이 가장 잘 읽는 상세 캡션으로 변환합니다
- 오픈 가중치: ComfyUI에서 완전한 로컬 제어
템플릿
모델과 함께 두 개의 템플릿 워크플로가 제공됩니다. 둘 모두 ComfyUI **0.45.0+**와 템플릿 팩 **0.11.104+**가 필요합니다.MiniMax-H3-Image 텍스트 기반 이미지 생성
텍스트 프롬프트로 이미지를 생성합니다. 템플릿은 정사각형 캔버스에서 4 MP로 열리며, VRAM이 적은 시스템에서 메모리가 부족해지지 않도록 의도적으로 모델의 기본 해상도보다 낮게 설정되어 있습니다. GPU에 여유가 있다면 해상도 선택기로 크기를 높이세요.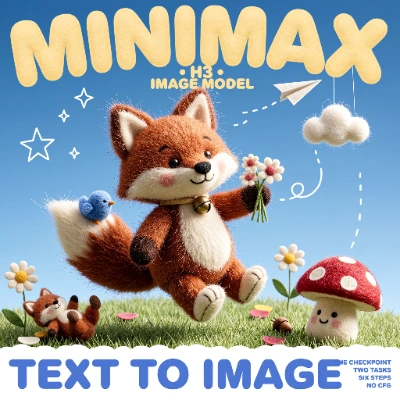
워크플로 다운로드
JSON을 다운로드하거나 템플릿 라이브러리에서 “MiniMax-H3-Image: Text to Image”를 검색하세요
MiniMax-H3-Image 이미지 편집
변경할 내용을 설명하면 이미지를 편집합니다. 템플릿은 소스를<Picture 1>로 불러오고, 입력한 지시문으로 참조를 인식하는 캡션을 만들며, 이전/이후 비교 노드로 마무리합니다.
워크플로 다운로드
JSON을 다운로드하거나 템플릿 라이브러리에서 “MiniMax-H3-Image: Image Edit”를 검색하세요
LoadImage 노드에서 <Picture 1>로 로드됩니다.
vintage_yellow_taxi.png
템플릿이 편집하는 소스 이미지
모델 다운로드
파일 4개를ComfyUI/models 아래에 배치합니다. 모두 Comfy-Org 미러 저장소에서 제공됩니다.
확산 모델: minimax_h3_image_pruned_int8_convrot.safetensors
프루닝된 INT8 DiT, 21 GB.
ComfyUI/models/diffusion_models/에 배치텍스트 인코더: qwen3vl_32b_minimax_h3_int8_convrot.safetensors
Qwen3-VL-32B, INT8, 25.28 GB.
ComfyUI/models/text_encoders/에 배치프롬프트 확장기: qwen3.5_9b_w4a8_gptq.safetensors
Qwen3.5 9B W4A8, 7.34 GB.
ComfyUI/models/text_encoders/에 배치VAE: minimax_h3_image_vae_fp16.safetensors
이미지 VAE, FP16, 1.17 GB.
ComfyUI/models/vae/에 배치샘플링 및 캔버스 크기
두 템플릿 모두 증류된 스케줄을 제공합니다:
가이드가 1이면 classifier-free guidance 패스가 없으므로 템플릿에는 네거티브 프롬프트가 포함되지 않습니다. 피하고 싶은 요소를 포함해 원하는 모든 내용을 포지티브 프롬프트에 작성하세요.
기본 출력은 약 16 MP입니다. 모든 변은 32 px의 배수로 생성되며, 너비와 높이는 임의의 값을 사용할 수 있습니다. 다음 크기는 일반적인 비율을 커버합니다:
더 작은 캔버스도 사용할 수 있으며 시간이 덜 걸립니다. 텍스트 기반 이미지 생성 템플릿에서 해상도 선택기는 화면 비율과 목표 메가픽셀 수를 별도로 설정하므로, 4 MP는 제한이 아니라 시작점입니다.
이미지 편집에서의 참조 이미지
이미지 편집 템플릿은 소스 이미지를<Picture 1>로 모델에 전송합니다. 추가 이미지는 순서대로 <Picture 2>, <Picture 3>으로 최대 16개의 참조까지 레이블이 지정되며, 프롬프트는 각 이미지를 해당 레이블로 지칭합니다. 첫 번째 이미지는 편집 대상이고, 나머지는 인물, 소품, 재질 또는 구도를 제공합니다. 짧은 지시문으로 충분합니다. 예를 들어 <Picture 1>의 차량을 <Picture 2>의 차량으로 교체하는 것입니다.
참조를 추가하려면 워크플로에 Load Image 노드를 하나 더 배치하고 프롬프트 생성 단계와 조건화 노드 모두에 연결합니다. 참조 이미지는 별도의 준비가 필요하지 않습니다. 템플릿이 소스를 32 px의 배수로 반올림하고, ComfyUI가 내부 복사본의 크기를 자체적으로 조정합니다. 비전 측에는 1024 px의 짧은 변을, VAE 측에는 1024~2048 px 사이로 제한된 짧은 변을 사용하며, 둘 다 32 px 그리드를 따릅니다.
편집 중 메모리가 부족해지면 템플릿에서 Resize Image/Mask 노드를 활성화하고 샘플링 전에 메가픽셀 값을 낮추세요.