

- 8 스텝, CFG 없음: 하나의 증류된 샘플링 스케줄과 단일 포지티브 조건화를 사용하며, 네거티브 프롬프트가 없습니다
- 8 메가픽셀: 정사각형, 4:3, 3:2, 16:9 및 그 세로 버전을 지원하며, 최대 3872 x 2176입니다
- 프롬프트 업샘플러 내장: 한 줄 요청이 전체 프롬프트로 확장되고, 확장된 프롬프트가 워크플로에 표시됩니다
- 참조 이미지를 사용한 편집: 첫 번째 이미지가 편집 대상이며, 이후 이미지는 프롬프트에서
<Picture 2>,<Picture 3>등이 됩니다 - 이미지 전용: P-H3-Image는 비디오나 오디오를 생성하지 않습니다
요구 사항
- ComfyUI 0.44.0 이상. 두 템플릿 모두 0.44.0에서 추가된 PH3ImageConditioning 노드를 사용합니다
- 약 35 GB의 모델 파일. diffusion 모델은 MiniMax H3 워크플로에서 사용하는 것과 동일하므로 이미 가지고 있을 수 있습니다
- int8 파일을 위한 약 21 GB VRAM의 GPU
모델 다운로드
디퓨전 모델(INT8)
minimax_h3_fl2va_pruned_int8_convrot.safetensors → ComfyUI/models/diffusion_models/
텍스트 인코더(INT8)
p-h3-image_text_encoder_int8_convrot.safetensors → ComfyUI/models/text_encoders/
프롬프트 업샘플러(W4A8)
p-h3-image_prompt_upsampler_w4a8.safetensors → ComfyUI/models/text_encoders/
VAE(INT8)
p-h3-image_vae_int8_convrot.safetensors → ComfyUI/models/vae/
LoRA(BF16)
p-h3-image_lora_bf16.safetensors → ComfyUI/models/loras/
P-H3-Image 텍스트 기반 이미지 생성 워크플로
한 줄 요청으로 8메가픽셀 이미지를 생성합니다. 템플릿은 프롬프트 업샘플러를 먼저 실행한 다음, 8단계 스케줄을 실행합니다.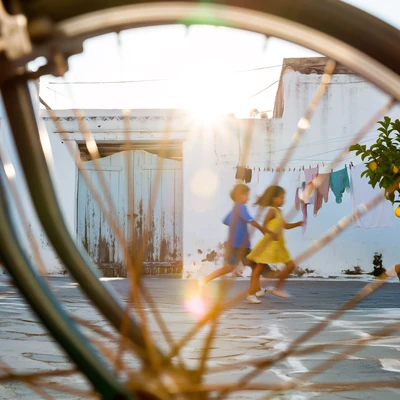
워크플로 다운로드
JSON을 다운로드하거나 템플릿 라이브러리에서 “P-H3-Image: Text to Image”를 검색하세요
Request: 뒤에 요청을 작성하고, Aspect ratio: 줄을 해상도 선택기와 일치하게 유지하세요. 선택기는 32의 배수로 8메가픽셀에 설정되어 있으며, 다음과 같은 캔버스가 만들어집니다:
- 샘플링: 8단계는 모델 자체의 스케줄입니다. 단계를 늘려도 디테일이 더해지지 않으며, 조정할 CFG나 네거티브 프롬프트가 없습니다
- 시드: 새 이미지에는
randomize로 설정하고, 배포된 예제를 재현하려면fixed로 되돌리세요 - 업샘플된 프롬프트: Preview Any 노드가 재작성된 프롬프트를 보여줍니다. 요청을 변경하기 전에 읽어볼 만합니다
P-H3-Image 이미지 편집 워크플로
짧은 지시문으로 사진을 편집하며, 최대 9개의 이미지를 함께 사용할 수 있습니다.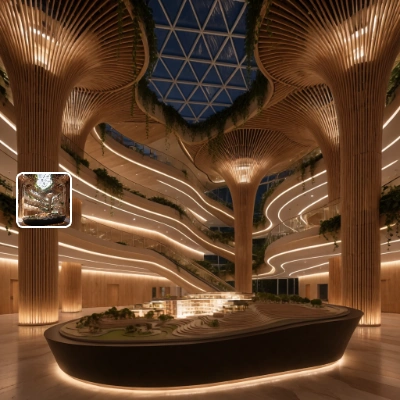
워크플로 다운로드
JSON을 다운로드하거나 템플릿 라이브러리에서 “P-H3-Image: Image Edit”를 검색하세요
입력 이미지: image_p_h3_image_edit_atrium_day.png
워크플로의 소스 이미지이며, 직접 촬영한 사진을 사용해도 됩니다.
Load Image에 불러오고, Request: 뒤에 원하는 결과를 설명하세요. 출력은 해당 이미지의 형태를 따르므로, 조건화 노드의 너비와 높이 입력은 0으로 유지합니다.
- 소스 크기: 편집 결과는 첫 번째 이미지의 크기로 렌더링되며, 최소 4메가픽셀까지 확대됩니다
- 참조 추가: 이미지를 추가로 연결하면 프롬프트에
<Picture 2>,<Picture 3>및 그 이후의 참조가 추가됩니다 - 유지할 것: 변경되면 안 되는 요소를 명시하세요. 그렇지 않으면 모델이 장면 전체를 다시 그리는 경향이 있습니다
프롬프트 작성 팁
- 이미지가 무엇인지 말하세요: “숙련된 거리 사진작가가 찍은 사진”이나 “두 가지 색상의 리소그래프 인쇄”처럼 실제 대상을 명명하는 문장으로 시작하세요. 이렇게 하면 스타일 단어보다 더 안정적으로 결과물의 느낌이 정해집니다
- 하나의 장면을 설명하세요: 시점, 한 순간을 포착한 하나의 주요 피사체, 몇 가지 보조 요소, 그리고 소스와 방향이 있는 라이트를 제시하세요
- 모든 텍스트 문자열을 인용하세요: 정확한 단어를 지정하지 않은 텍스트는 의사 텍스트로 변합니다. 각 문자열을 따옴표로 묶고, 짧게 유지하고, 어디에 위치하는지 말하고, “no other text”로 끝내세요
- 과장된 단어는 빼세요: stunning, epic, cinematic, 8k 같은 단어는 모델을 광택이 나고 과도하게 채도가 높은 모습으로 몰아갑니다
제한 사항
- 해상도가 낮을수록 아티팩트가 더 많이 나타남: 얼굴, 손, 작은 세부 정보는 8메가픽셀보다 2메가픽셀, 4메가픽셀에서 더 자주 깨집니다
- 손과 배경 인물이 깨질 수 있음: 배경에 있는 작은 인물은 왜곡되어 나올 수 있습니다. 8메가픽셀로 렌더링하면 도움이 됩니다
- 텍스트는 완전히 신뢰할 수 없음: 짧은 인용 문자열은 잘 렌더링되지만, 본문 텍스트나 긴 코드처럼 밀도가 높은 텍스트는 유사 텍스트로 변합니다
- 프롬프트에 민감함: 프롬프트가 너무 길면 이미지 품질이 떨어지고, 너무 짧으면 업샘플러 없이는 약한 결과가 나옵니다