**Z-Image(造相)**は、AlibabaのTongyi Labが開発した、6Bパラメータを持つ強力かつ高効率な画像生成モデルです。Scalable Single-Stream DiT(S3-DiT)アーキテクチャを採用し、テキスト、視覚意味トークン、画像VAEトークンをシーケンスレベルで連結して統一入力ストリームとすることで、パラメータ効率を最大化しています。 Z-Image(Base)は、コミュニティ主導のファインチューニングやカスタム開発向けに設計された非蒸留の基盤モデルです。 モデルのハイライト:
  • フォトリアリスティック品質: 高い美的品質を維持しながら、優れたフォトリアリスティックな画像生成を実現
  • 正確なバイリンガルテキストレンダリング: 複雑な中国語と英語のテキストを正確にレンダリング
  • プロンプト強化&推論: プロンプトエンハンサーによりモデルに推論能力を付与
  • ファインチューニング対応: カスタムトレーニングや適応に理想的なベースモデル
関連リンク:

Z-Image テキストから画像へ ワークフロー

ComfyUI が最新版に更新されていることを確認してください。このガイドで紹介するワークフローは、ワークフローテンプレートから入手できます。 テンプレート内に該当のワークフローが見つからない場合、ComfyUI のバージョンが古くなっている可能性があります。ワークフローを読み込んだ際にノードが欠落している場合の考えられる原因:
  1. 最新の ComfyUI(Nightly 版)を使用していない
  2. 起動時に一部のノードのインポートに失敗している

Z-Image: テキストから画像へ

創造的自由の基盤。多様な美的スタイルと卓越した写真的品質を備え、ファインチューニングに最適。ネガティブプロンプトに反応し、高い生成多様性を実現。 Z-Image テキストから画像へワークフローのプレビュー
Comfy Cloudで実行

このワークフローをComfy Cloudで直接実行

ワークフローをダウンロード

Z-Image テキストから画像へワークフローのJSONファイルをダウンロード
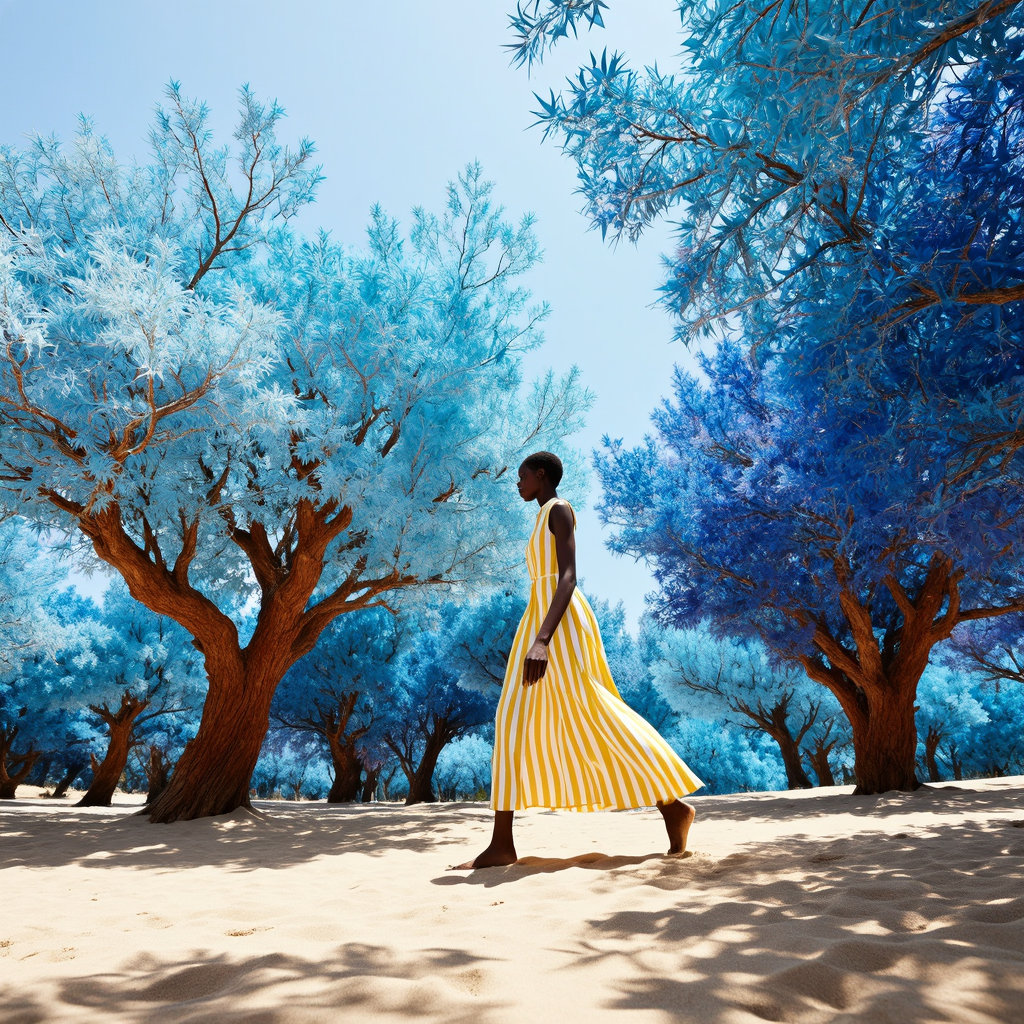
出力例 Z-Imageの出力例

Z-Image model downloads

qwen_3_4b.safetensors

Text encoder for Z-Image.

z_image_bf16.safetensors

Diffusion model for Z-Image.

ae.safetensors

VAE for Z-Image.
Model Storage Location