

- Capacidad de edición inherente: cada capa se puede manipular de forma independiente sin afectar el contenido de las demás
- Operaciones elementales de alta fidelidad: admite cambiar el tamaño, la posición y el color con aislamiento físico de los componentes semánticos
- Descomposición en cantidad variable de capas: no se limita a un número fijo de capas; descompón en 3, 4, 8 o más capas según lo necesites
- Descomposición recursiva: cualquier capa se puede descomponer aún más, lo que permite una profundidad de descomposición infinita
Flujo de trabajo de Qwen-Image-Layered
Descomposición con Qwen-Image-Layered
Descompón una imagen en capas RGBA editables para recolorar, reemplazar, redimensionar y reposicionar.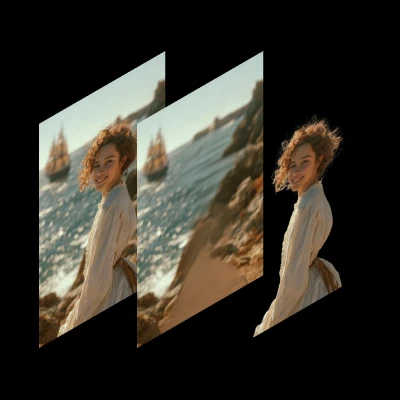
Descargar flujo de trabajo
Descarga el archivo JSON del flujo de trabajo
Ejecutar en Comfy Cloud
Ejecuta ComfyUI en línea sin configuración
LoadImage 74:
coastal_smiling_woman.png
Nodo
LoadImage 74 · coastal_smiling_woman.png
Enlaces de modelos
text_encoders diffusion_models vae Ubicación de almacenamiento de los modelosVersión FP8
Por defecto usamos bf16, que requiere mucha VRAM. Si necesitas un uso de VRAM menor, puedes usar la versión fp8: Después, actualiza el nodo Load Diffusion model dentro del Subgraph para usarla.Capas y salida
El número de capas lo define el widgetlayers del nodo Latente Qwen Image en capas vacío, dentro del Subgraph.
Este modelo regenera la imagen completa además de las capas, así que una generación siempre decodifica layers + 1 imágenes:
La primera imagen es la imagen completa, no una capa. El flujo de trabajo de imagen a capas la descarta automáticamente con un nodo
Cortar latente (dim t, index 1) antes de la división del lote, por lo que la plantilla genera layers imágenes. Si construyes un gráfico personalizado sin ese nodo, descarta la primera imagen cuando solo quieras las capas. layers acepta 0, lo que te da esa imagen por sí sola.
Recomponer todas las capas vuelve a crear la imagen completa. Úsalo como comprobación: si al apilar las capas no se reproduce la primera imagen, la descomposición no hizo lo que querías.
Cómo las capas se convierten en imágenes separadas
El nodo Latente Qwen Image en capas vacío asigna un latente 5D con forma[batch_size, 16, layers + 1, height // 8, width // 8]. Las capas ocupan el tercer eje, el mismo eje temporal que los modelos de video usan para los fotogramas. El nodo Cortar latente a lote con dim en t mueve ese eje a la dimensión del lote, de modo que después de la Decodificación VAE cada capa es una imagen separada dentro del lote. La plantilla inserta un nodo Cortar latente (dim t, index 1) antes de Cortar latente a lote para descartar la entrada de la imagen completa, así que el lote decodificado contiene solo las capas.
La posición de una capa en la pila es, por lo tanto, su índice en el lote, contando desde la imagen completa en el índice 0. No existe un campo de z-index ni metadatos por capa que lleven ese orden, así que reordenar o filtrar el lote reordena las capas.
El VAE de Qwen-Image-Layered decodifica a 4 canales, por lo que las capas decodificadas llevan un canal alfa.