

- 1 つのモデルで生成と編集: 同じ重みがテキストから画像へのプロンプトと編集指示の両方に対応するため、ワークフローでチェックポイントを切り替える必要がありません
- ネイティブ 2K 出力: 小さい結果をアップスケーリングするのではなく、最大 2048x2048 で直接生成できます
- プロフェッショナルなタイポグラフィ: 高密度の小さなテキストや複雑なレイアウトも維持されるため、インフォグラフィック、スライド、UI モックアップ、ポスター、パッケージデザインに適しています
- アルファチャンネルのサポート: VAE が 4 つのチャンネルを持つため、透明な背景の画像を直接生成および編集でき、後から切り抜く必要がありません
- マルチ画像編集: 参照画像はスロットの順序でテキストエンコーダーに結合されます。Text Encode Qwen Image 2.1 ノードは最大 16 スロット(
image_1からimage_16)を受け付け、このページの 2 つの編集テンプレートは最初の 10 個(image_1からimage_10)を接続しています。image_1は編集対象の画像で、残りは内容を補うためのものです。プロンプトはインデックスでそれらを参照します。たとえばimage_1は<image1>と記述します - ローカル編集: 変更したいオブジェクトや領域を記述すると、画像の残りの部分は保持されます
Qwen-Image-2.1 ワークフロー
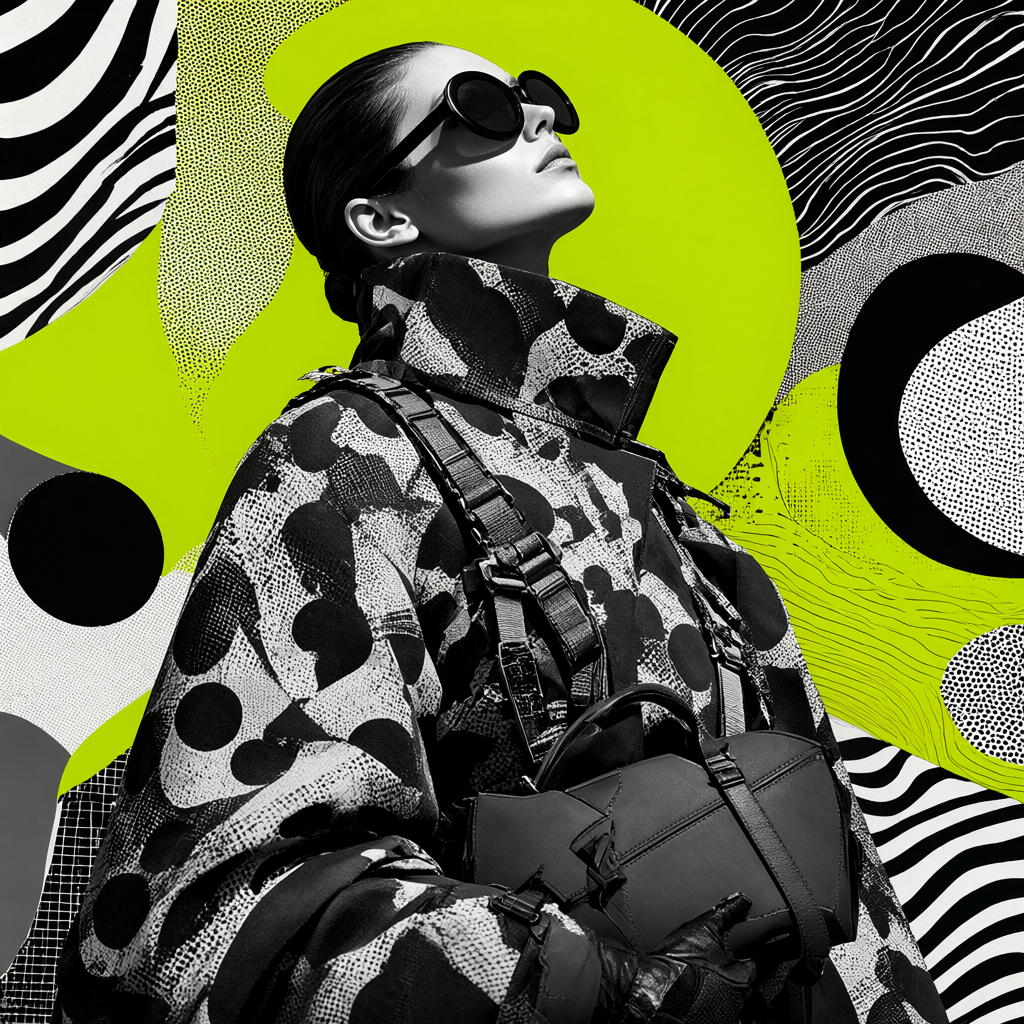
Qwen Image 2.1 テキストから画像へ
選択したアスペクト比とメガピクセル数に合わせて、テキストプロンプトから画像を生成します。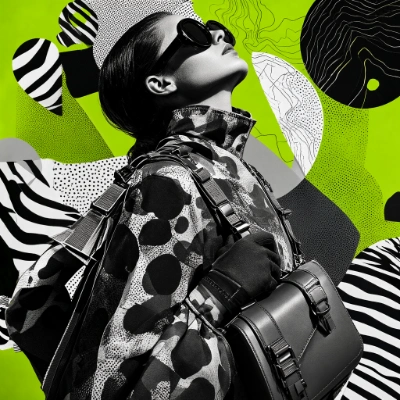
ワークフローをダウンロード
JSON をダウンロードするか、テンプレートライブラリで「Qwen-Image-2.1」を検索してください
Comfy Cloud で実行
セットアップ不要で ComfyUI をオンライン実行
Qwen Image 2.1 画像編集
指示に従って画像を編集します。編集にソース画像にないコンテンツが必要な場合は、参照画像を追加してください。たとえば、2 枚目の写真の衣服を 1 枚目の人物に着せる場合などです。
ワークフローをダウンロード
JSON をダウンロードするか、テンプレートライブラリで「Qwen-Image-2.1」を検索してください
Comfy Cloud で実行
セットアップ不要で ComfyUI をオンライン実行
LoadImage ノードにアップロードしてください:
portrait_model_denim.png
LoadImage ノード 470 · portrait_model_denim.pngclothing_light_blue_denim_shirt.png
LoadImage ノード 475 · clothing_light_blue_denim_shirt.png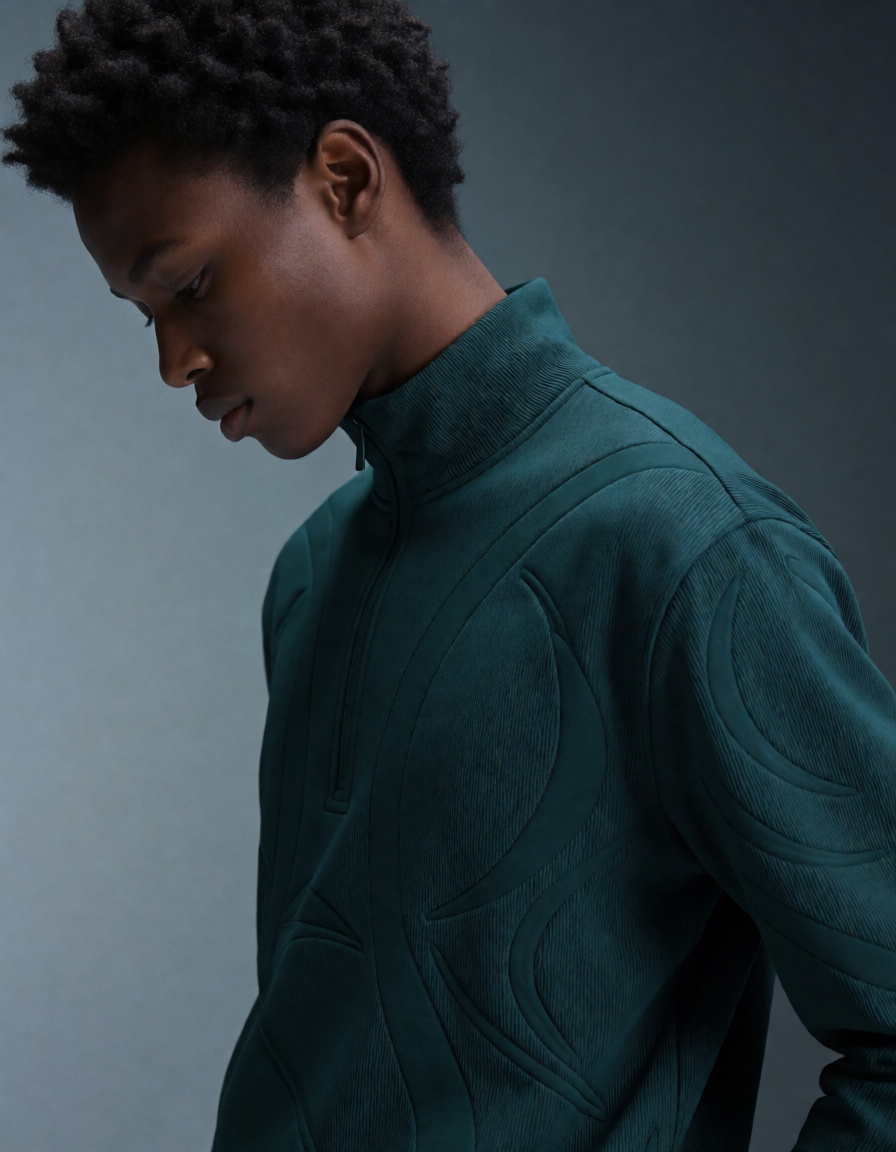
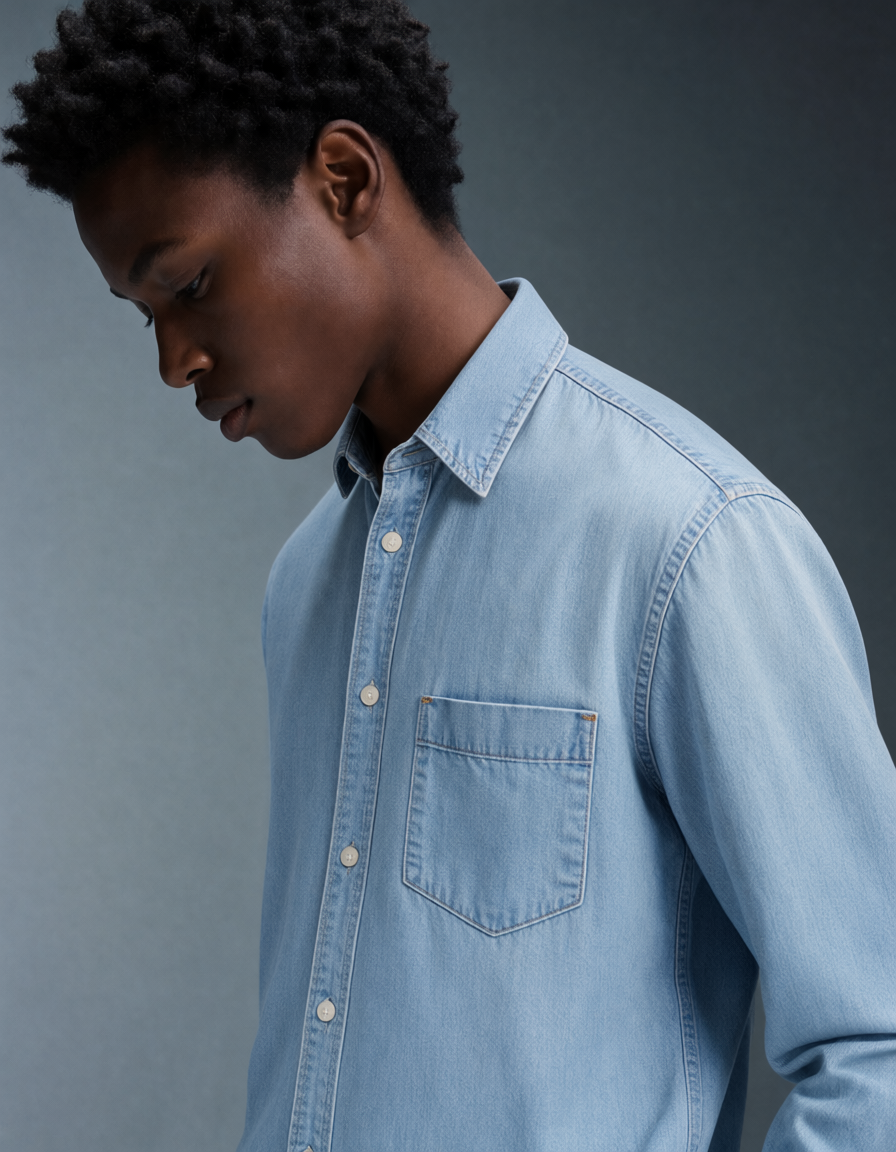
背景の削除: Qwen Image 2.1
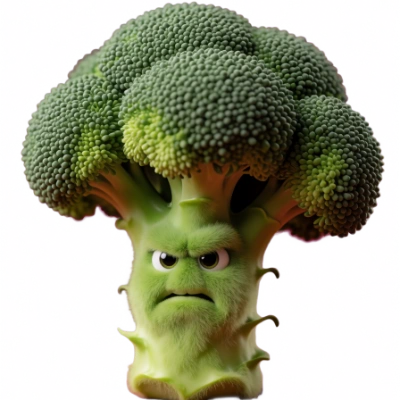
編集指示で写真の背景を削除します。このワークフローは画像編集のサブグラフを再利用し、プロンプトはRemove the background, and output a PNG image です。結果は元画像と比較できます。
ワークフローをダウンロード
JSON をダウンロードするか、テンプレートライブラリで「Qwen-Image-2.1」を検索してください
Comfy Cloud で実行
セットアップ不要で ComfyUI をオンライン実行
LoadImage ノードにアップロードしてください:
angry_broccoli.png
LoadImage ノード 470 · angry_broccoli.pngQwen Image 2.1 Turbo: テキストから画像へ
Qwen Image 2.1 Turbo でテキストプロンプトから画像を生成します。同じモデルの蒸留チェックポイントで、ベースモデルの 25 ステップではなく 8 ステップでサンプリングします。出力サイズは同じ Resolution Selector ノードで決まり、任意のプロンプト強化の挙動もベースワークフローと同じです。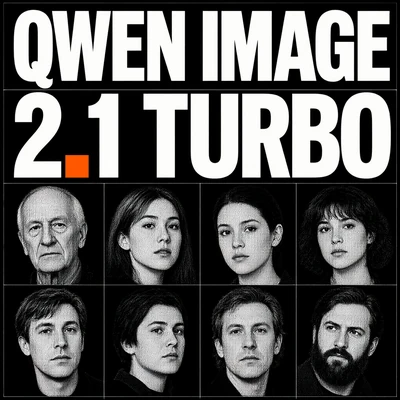
ワークフローをダウンロード
JSON をダウンロードするか、テンプレートライブラリで「Qwen Image 2.1 Turbo」を検索してください
Comfy Cloud で実行
セットアップ不要で ComfyUI をオンライン実行
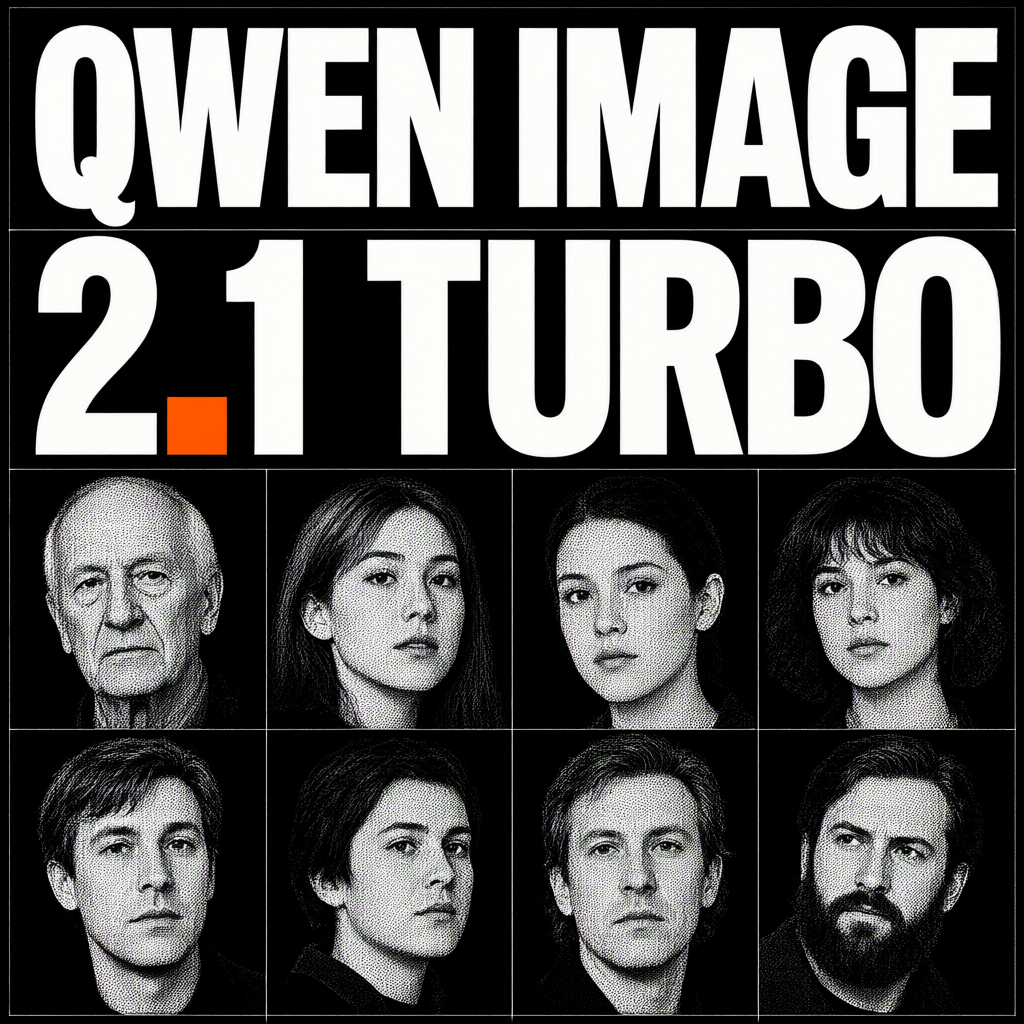
Qwen Image 2.1 Turbo: 画像編集
同じ 8 ステップの Turbo チェックポイントで、指示に従って画像を編集します。参照スロットの扱いはベースの画像編集ワークフローと同じです。image_1 が編集対象で、残りのスロットが内容を提供し、プロンプトは <image1>、<image2> のようにインデックスで指定します。
ワークフローをダウンロード
JSON をダウンロードするか、テンプレートライブラリで「Qwen Image 2.1 Turbo」を検索してください
Comfy Cloud で実行
セットアップ不要で ComfyUI をオンライン実行
LoadImage ノードにアップロードしてください:
ballet_dancer_photography_minimalist_architecture.png
LoadImage ノード 470 · ballet_dancer_photography_minimalist_architecture.png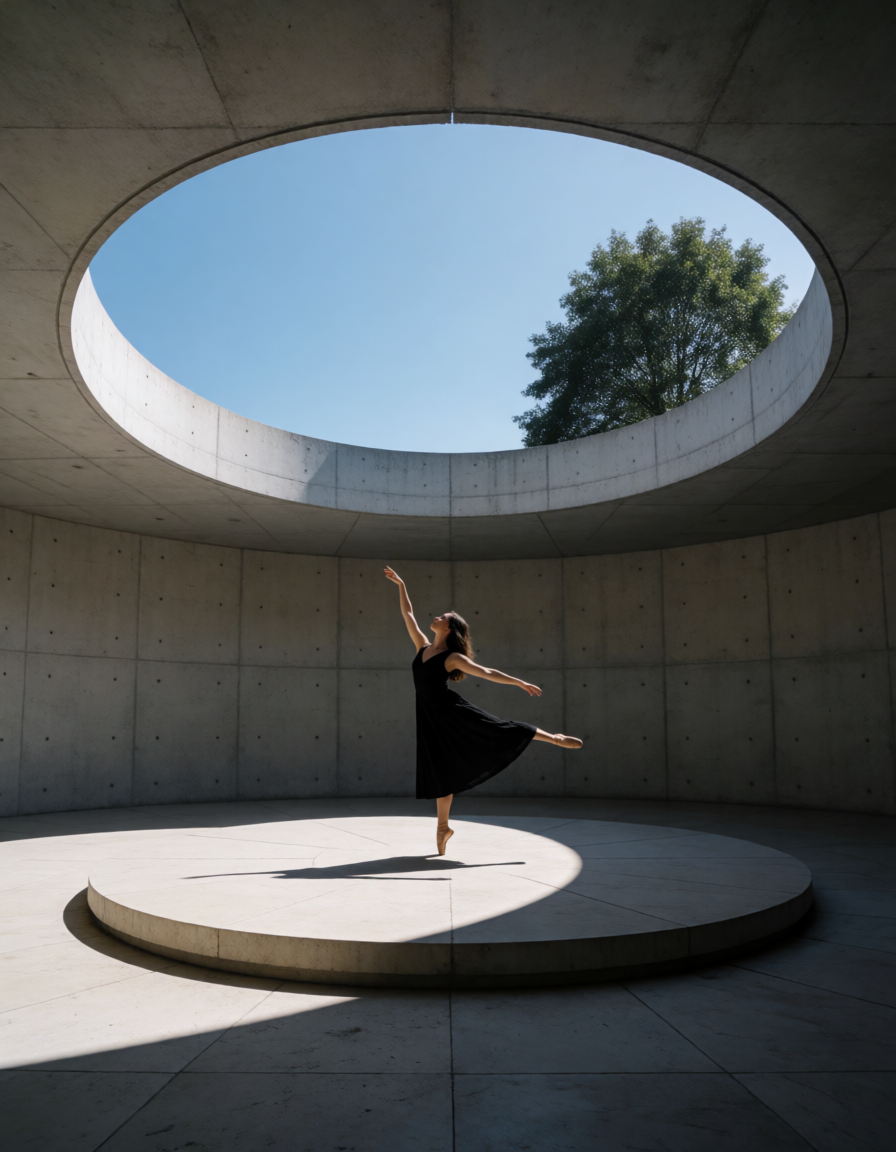
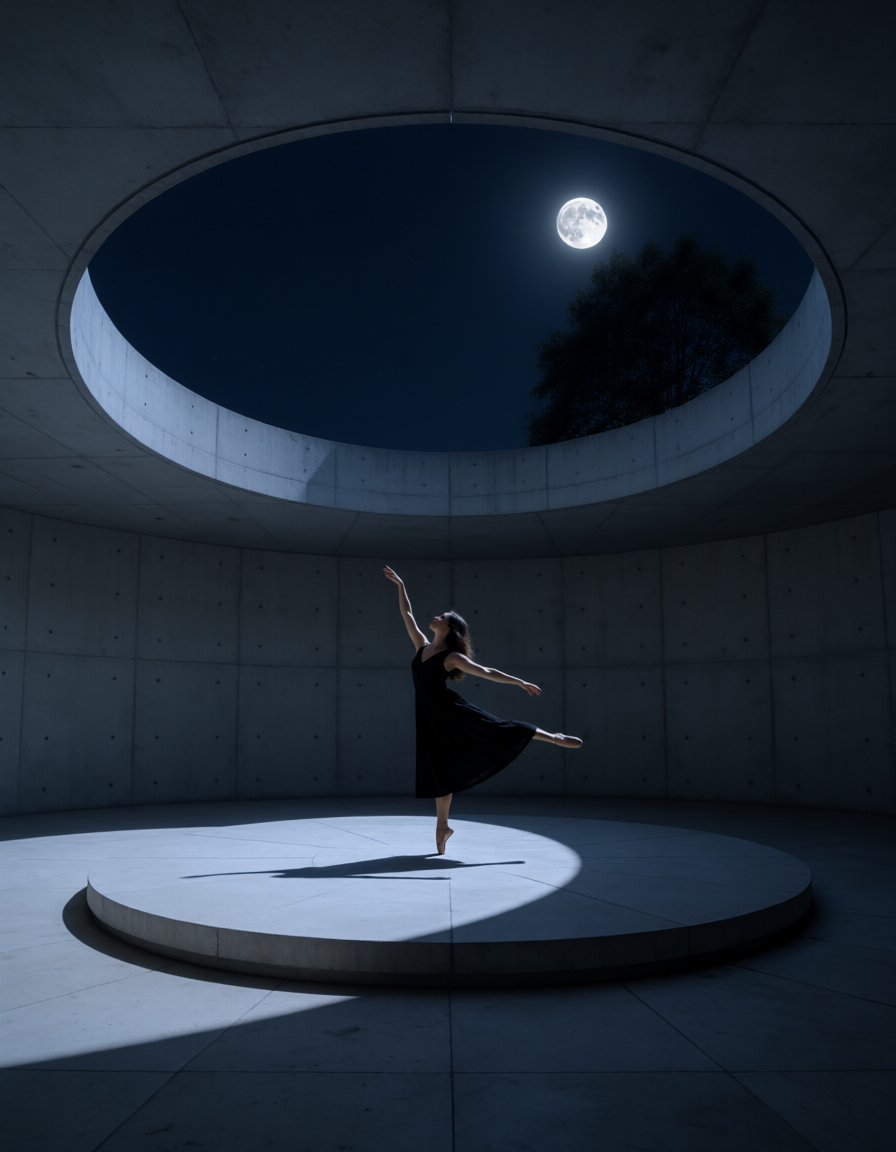
モデルのダウンロード先
このページのすべてのワークフローは同じ VAE とベースのテキストエンコーダーを共有しており、Text to image と Image edit のテンプレートはそれぞれプロンプト強化用のテキストエンコーダーを追加で読み込みます。Text to image はqwen3.5_9b_qwen_image_2.1_pe_t2i、Image edit は qwen3.5_9b_qwen_image_2.1_pe_i2i です。2 つの Turbo テンプレートは、ベースモデルの代わりに Turbo diffusion モデルを読み込みます。
text_encoders
- qwen3vl_8b_int8_convrot.safetensors(テンプレートが読み込むデフォルト、メモリ使用量は少なめ)
- qwen3vl_8b_bf16.safetensors(フル精度、より多くのメモリが必要)
- qwen3.5_9b_qwen_image_2.1_pe_t2i.int8_convrot.safetensors(Text to image テンプレートのプロンプト強化)
- qwen3.5_9b_qwen_image_2.1_pe_i2i.int8_convrot.safetensors(Image edit テンプレートのプロンプト強化)
- qwen_image_2.1_int8_convrot.safetensors(ベースのテンプレートが読み込むデフォルト、メモリ使用量は少なめ)
- qwen_image_2.1_bf16.safetensors(フル精度、より多くのメモリが必要)
- qwen_image_2.1_turbo_int8_convrot.safetensors(Turbo テンプレートが読み込むデフォルト、メモリ使用量は少なめ)
- qwen_image_2.1_turbo_bf16.safetensors(Turbo のフル精度、より多くのメモリが必要)
ワークフロー設定
サンプラー設定
ベースのワークフローはsteps 25、cfg 1、euler サンプラー、simple スケジューラーでサンプリングします。2 つの Turbo テンプレートは代わりに 8 ステップで、cfg 1、euler サンプラー、蒸留チェックポイントに付属する固定の ManualSigmas スケジュールでサンプリングします。そのためステップ数を増やす場合はスケジュールも併せて変更してください。
cfg が 1 のとき ComfyUI はネガティブ条件の計算をスキップするため、これらのワークフローではネガティブプロンプトが効果を持ちません。テンプレートは Qwen-Image-2.1 が公開されている経路である cfg 1 を維持しており、ネガティブプロンプトを効かせたい場合にのみ上げてください。cfg 2 では、小さな文字や数字を含む密なプロンプトへの追従性が上がりますが、その代わりエッジが過剰に強調されます。それより上げると露出が明るすぎたり暗すぎたりする方向に振れ、cfg 5 では品質が大きく低下し、cfg 0.5 では画像が壊れます。値は一度に 1 つだけ変え、固定シードで比較してください。
steps はベースのワークフローにおける 2 つ目の調整項目です。2 つの Turbo テンプレートは固定の 8 ステップ ManualSigmas スケジュールを使うため、以下のステップ数の目安はベースモデルに当てはまります。Qwen-Image-2.1 の公開パイプラインは euler サンプラーで約 40 から 50 ステップを使用しており、ベースのテンプレートはより低い 25 から始まります。単純な局所編集は 4 から 8 ステップでも成立するため、服の色を変えるといった指示はデフォルトより数倍速く生成できます。一方、画面全体を書き換える編集は一貫性を失い、25 ステップが必要です。手や指のような収束しにくい細部は 30 ステップ程度で落ち着き、25 から 40 ステップに上げると細部のざらつきが減ります。steps は、特定の箇所がどうしても収束しないときだけ調整してください。
解像度
Text to image:Resolution Selector ノードがアスペクト比とメガピクセルの目標値を設定します。1.0 MP はおよそ 1024x1024 です。Qwen-Image-2.1 は 2K をネイティブに生成するため、2048x2048 の正方形出力を得るには目標値を約 4.0 MP に設定してください。 Image edit:キャンバスは Image Edit サブグラフノードのresolution コントロールで決まります(範囲 0 から 4096、ステップ 32)。ノード自体のデフォルトは 1024 で、テンプレートは 0 で配布されています。テンプレートのデフォルトである custom_size オフの場合、編集は最初の参照画像 image_1 のサイズで生成されます:
resolutionが0の場合、各参照画像は自身のピクセルサイズのまま(32 の倍数に丸めて)保持されるため、3000x4000 の写真は 3008x4000 のキャンバスになりますresolutionが0より大きい場合、image_1のアスペクト比をresolutionxresolutionピクセルの予算に合わせてスケーリングします。これは幅や高さではなく総ピクセル数であり、32 の倍数に丸められるため、同じ写真でresolution1024は約 896x1184 になります
custom_size をオンにすると、代わりに Resolution Selector からキャンバスを取得します。このときはリサイズ後の image_1 のサイズに近い値にしてください。そうしないと編集がずれる可能性があります。
コストを決めるのはキャンバスサイズです。3000x4000 の参照画像は resolution が 0 のとき 3008x4000(約 12 MP)でサンプリングされ、同じ編集を resolution 1024 にすると約 896x1184(約 1 MP)になります。RTX 5090 ではおよそ 6 s/it と約 0.3 s/it の差になります。resolution を下げると生成結果が小さくなることで速くなり、細部が増えるわけではありません。編集が遅いと感じたら、他の設定を触る前に resolution と参照画像のピクセルサイズを確認してください。大きな参照画像を複数使うとさらに遅くなり、そのコストには下記の KV キャッシュ設定が影響します。また、モデルの学習済み 2K を大きく超える目標値(4K など)はプロンプト追従性が落ちます。
画像編集のためのプロンプト
参照画像はスロット順にテキストエンコーダーへ連結され、プロンプトは各画像をインデックスで指定します:image_1 を供給する LoadImage ノード(ノード 470:ノードを右クリックし、マスクエディタで開く を選択)で Paint Pen を使い、領域を塗って保存します。Paint Pen はマスクではなく画像の RGB レイヤーに描画するため、保存するとマーク付きの画像がノードに書き戻され、マークはこの編集が読み込む参照画像の一部になります。プロンプトでマークの色を指定すると、その指示をその領域に向けられます(例:「赤い領域のジャケットを変更する」)。マークは変更したい領域内にとどめてください。マークの色が結果に現れる場合は、希望する色もプロンプトに書いてください。
KV キャッシュ
編集ワークフローには Qwen Image 2.1 Cache ノードが含まれており、サンプリングのステップ間でキャッシュされたテキストと参照プレフィックスを保持します。テンプレートのデフォルト設定はほとんどの環境でそのまま使えます。 このノードは実験的な機能で、2 つのコントロールがあります:プロンプト強化
Text to image と Image edit のテンプレートには、任意のプロンプト強化ステップが含まれます。専用のテキストエンコーダーがサンプリング前にプロンプトを書き換え、短いリクエストをより詳細な記述に展開します。 4 つのテンプレートはいずれも、Qwen Image 2.1 サブグラフノードに次のコントロールを公開しています:refine_prompt:4 つのテンプレートすべてでデフォルトはオフです。オンにすると、画像モデルは入力したプロンプトではなく書き換え後のプロンプトでサンプリングしますPE_model:書き換えを行うテキストエンコーダーです。Text to image はqwen3.5_9b_qwen_image_2.1_pe_t2i.int8_convrot.safetensors、Image edit はqwen3.5_9b_qwen_image_2.1_pe_i2i.int8_convrot.safetensorsを使用しますthinking_mode(画像編集テンプレートではthinkingと表示):4 つのテンプレートすべてでデフォルトはオフです。このチェックポイントは推論ブロック込みで学習されており、オフにすると品質が落ちるため、max_lengthを上げてからrefine_promptと一緒にオンにしてくださいmax_length:推論ブロックと書き換え後のプロンプトで共有するトークン予算です。すべてのテンプレートで 4096、ノードでは 32768 まで設定できます
refine_prompt がオンのときだけ評価されるため、強化用テキストエンコーダーは 4 つのテンプレートすべてで任意です。使用するには refine_prompt をオンにしてください。背景除去テンプレートにはこのステップはありません。
テンプレートはいずれも max_length を 4096 にしており、1 回の書き換えが何分も続かないようにしています。プロンプト強化モデルのカード(T2I、I2I)では max_new_tokens 16256(Text to image)と 24000(Image edit)でサンプリングし、いずれも thinking をオンにしています。推論ブロックが 4096 の予算を使い切ると閉じず、強化器は空文字列を返します。Preview Any には何も表示されず、画像モデルはその空のプロンプトでサンプリングします。画像編集は入力に近い結果を返し、Text to image はリクエストが完全に失われます。thinking をオンにする前に max_length をモデルカードの値まで上げてください。書き換えごとの待ち時間は長くなります。
VAE デコードのアーティファクト
Qwen-Image-2.1 標準の VAE は、ディテールの多い写実的な出力に細かいチェッカーボード状のテクスチャを残すことがあります。これはサンプリングではなくデコーダーに起因するため、ステップ数を増やしても解消しません。 texture_fix_vae_for_qwen_image_2.1_bf16.safetensors は同じデコーダーの非公式なファインチューンで、同じ latent をよりクリーンなテクスチャでデコードします。ComfyUI/models/vae/ に配置し、Load VAE ノードで qwen_image_2.1_vae_bf16.safetensors の代わりに選択してください。再構成精度を少し犠牲にしてテクスチャを改善します。
Turbo LoRA で高速にサンプリングする
ベースチェックポイント用の Turbo LoRA は 8 ステップ、cfg 1 でサンプリングします。公式ファイルは Comfy-Org/Qwen-Image-2.1 リポジトリの qwen_image_2.1_turbo_lora_avg_rank_178_bf16.safetensors です。ComfyUI/models/loras/ にダウンロードし、LoraLoaderModelOnly ノードでサンプラーへ渡すモデルラインに読み込みます。
Turbo ワークフロー は別の方法を取ります。専用の Turbo 拡散モデルと、固定の 8 ステップ ManualSigmas スケジュールの組み合わせです。LoRA はベースチェックポイントを再利用するため、そのモデルをもう 1 つダウンロードする必要はありません。ベースのテンプレートはもともと cfg 1 で euler と simple を使うので、Qwen Image 2.1 のサブグラフノードで steps を 8 にし、サンプラーとスケジューラはテンプレートのままにしてください。
Lightning LoRA で高速にサンプリングする
ベースのワークフローは 25 ステップでサンプリングします。Qwen-Image-2.1-Lightning は、同じベースチェックポイント向けの非公式な 4 ステップ蒸留 LoRA です。pytorch_lora_weights.safetensors をComfyUI/models/loras/ にダウンロードし、LoraLoaderModelOnly ノードでサンプラーへ渡すモデルラインに読み込みます。
この LoRA は cfg 1、4 ステップのスケジュールで動作します。モデルカードに記載されている 1.0, 0.75, 0.5, 0.25 のグリッドは、スケジュールに適用される指数シフト(exponential shift)を通す前の値で、サンプラーが実際に使う値ではありません。ComfyUI の Qwen-Image-2.1 のサンプリング設定には同じシフトが 1024x1024 に合わせて組み込まれているため、steps を 4 にしてテンプレートの euler と simple をそのまま使うと、蒸留時のスケジュール(およそ 1.0, 0.857, 0.667, 0.4)が再現されます。Qwen Image 2.1 のサブグラフノードで steps を 4 に設定し、スケジューラはテンプレートのままにしてください。
ManualSigmas ノードは実験的とされており、入力した数値をそのまま渡すため、手書きのスケジュールにはシフト後の値を最初から入れる必要があります。ComfyUI のシフトは 1024x1024 に合わせてあるので、出力サイズが離れるほど一致度は下がります。
アルファチャンネル出力
Qwen-Image-2.1 の VAE は 4 チャンネルをデコードするため、デコード後の画像は RGB に加えてアルファを持ちます。背景除去ワークフローはこれに依存しています。透明な背景は後から切り抜くのではなく、アルファチャンネルに生成されます。 3 チャンネル画像を前提としたノードやカスタムノードは、この出力で失敗することがあります。エラーは Qwen-Image-2.1 のノードではなく、画像を受け取る側のノードに表示されます。デコードの後にSplitImageWithAlpha ノードを挿入し、その RGB 出力をそれらのノードに接続してください。どちらのノードも 1 が透明ピクセルを表すマスクの約束に従うため、一方のマスク出力はそのまま JoinImageWithAlpha のアルファ入力に接続できます。